Leggere automaticamente numero, data e importo da un documento può eliminare passaggi ripetitivi. Il salto successivo, però, è più delicato: decidere se quei dati possano aggiornare un gestionale o avviare un’attività. L’estrazione produce un’ipotesi strutturata. L’autorizzazione richiede regole, contesto e responsabilità. Tenere distinti i due livelli rende l’automazione più utile e più controllabile.
Separare acquisizione, interpretazione e decisione
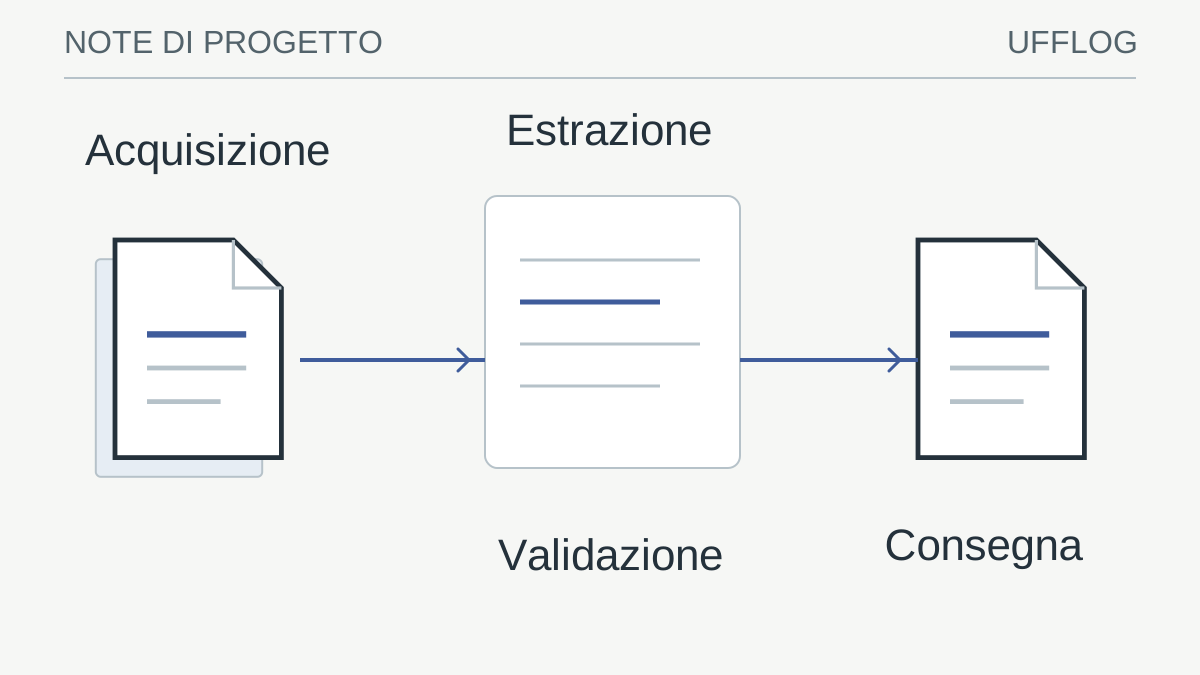
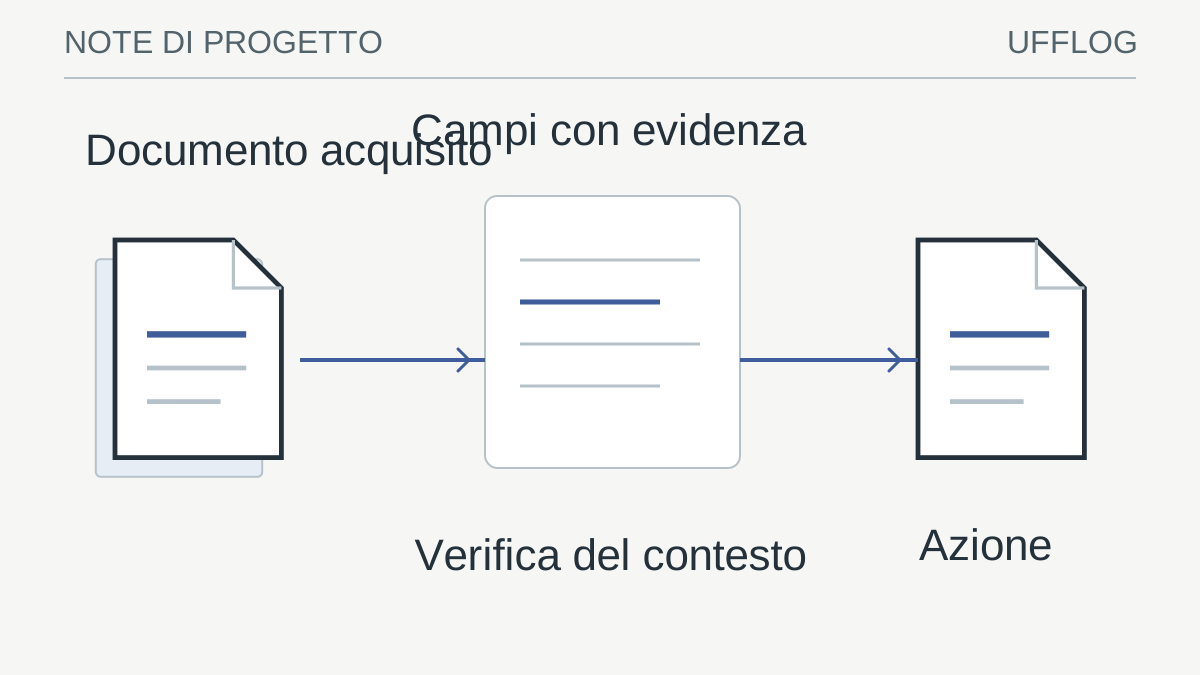
Il processo comincia con il documento e la qualità della sua acquisizione. Poi un motore riconosce testo, struttura o campi. Un livello successivo controlla i dati rispetto alle regole dell’azienda. Solo dopo si decide se proporre una registrazione, chiedere una revisione o eseguire un’azione consentita. Questa separazione aiuta a localizzare gli errori e correggere il componente giusto.
Per esempio, una data non riconosciuta può dipendere da una scansione poco leggibile; un numero corretto associato al campo sbagliato è un problema diverso. Se tutto confluisce in un unico “esito AI”, diventa difficile capire perché la procedura si ferma. Una pipeline leggibile consente di migliorare il risultato senza riprogettare ogni passaggio.
Delimitare i documenti ammessi prima di interpretarli
Il progetto deve stabilire quali famiglie documentali entrano nel percorso automatico. Un modello capace di leggere molte pagine non implica che l’organizzazione abbia autorizzato ogni tipo di documento. Definisci formato, completezza minima e informazioni necessarie a riconoscere il caso. Un documento estraneo deve essere indirizzato a un percorso appropriato, senza forzarlo nello schema della famiglia più simile.
Considera uno scenario illustrativo con rapporti di intervento. Il flusso può richiedere riferimento della pratica, attività svolta e firma visibile, mentre un allegato commerciale ricevuto per errore segue regole diverse. La classificazione automatica può proporre la categoria, ma il progetto deve decidere cosa fare quando non ci sono evidenze sufficienti. Non basta assegnare comunque una classe per evitare che la coda sembri incompleta.
Prepara un campione con documenti ammessi, esclusi e ambigui. Per ciascuno definisci il percorso atteso prima del test. Controlla che un documento incompleto non venga promosso a registrazione soltanto perché i campi presenti sono leggibili. Un foglio aggiuntivo può modificare il significato della pratica; la validazione deve considerare l’unità documentale, non soltanto una pagina selezionata dal motore.
Il contenuto acquisito resta inoltre materiale da analizzare. Un’istruzione stampata dentro il documento non deve cambiare autorizzazioni, destinatari o regole del backend. L’eventuale agente interpreta il testo all’interno del compito assegnato; il componente applicativo conserva il controllo sulle azioni disponibili. Questa separazione permette di usare estrazione e classificazione senza trasformare qualsiasi frase del documento in una delega operativa.
Il risultato della fase di ingresso è quindi un caso riconosciuto, con limiti e riferimenti sufficienti per proseguire. Quando questi elementi mancano, il flusso può chiedere una nuova acquisizione o passare a un referente. L’astensione corretta è un esito del servizio, non un errore da nascondere con valori ipotizzati.
Conservare il legame fra campo e documento originale
Un valore estratto diventa più verificabile quando conserva la provenienza: documento, pagina, area da cui è stato letto e versione del risultato. Il revisore deve poter vedere «questo totale proviene da questa zona» senza cercare a mano fra molte pagine. Se il motore non offre coordinate o riferimenti sufficienti, la limitazione va considerata nella scelta del flusso e nei tempi della revisione. Una tabella ordinata non sostituisce l’evidenza da cui è stata ricavata.
Mantieni separati valore originale riconosciuto, valore normalizzato e valore accettato. La stringa «1.250,00» può essere convertita in una rappresentazione numerica interna, ma il passaggio deve rispettare lingua, separatori e convenzioni del documento. Non eliminare l’originale prima della verifica. Quando una persona corregge un campo, conserva il motivo e il riferimento alla versione, evitando che una successiva rielaborazione sovrascriva la decisione senza renderlo evidente.
Considera anche il documento come unità. Due pagine possono appartenere alla stessa fattura, oppure essere state unite per errore durante la scansione. Un motore capace di leggere ogni campo non risolve automaticamente l’associazione fra pagine. L’ingresso deve rilevare documenti incompleti, copie duplicate e allegati estranei. L’identificativo di acquisizione aiuta a seguire il percorso senza usare il nome del file come unica prova di identità.
Il flusso di scansione e OCR parte proprio da questi aspetti: qualità dell’acquisizione, ordine e destinazione. Se le scansioni arrivano già confuse, aumentare la complessità del modello può rendere più costosa l’interpretazione senza correggere la causa. Il primo miglioramento spesso consiste nel rendere stabile e osservabile il materiale che entra nel processo.
La confidenza aiuta, ma non decide da sola
Alcuni servizi documentali restituiscono un valore di confidenza associato all’estrazione. Microsoft ne documenta l’uso e il rapporto con l’accuratezza. Il valore non è una garanzia universale e non dovrebbe essere interpretato come un’autorizzazione implicita. Occorre verificare il comportamento sul tipo di documento e sul campo che interessa.
Una soglia uguale per tutti i campi può essere poco sensata. Un riferimento descrittivo e una coordinata bancaria hanno impatti differenti. Anche un campo letto con alta confidenza può essere incoerente con altre informazioni. La progettazione combina segnali del modello, controlli deterministici e revisione, in funzione delle conseguenze dell’errore.
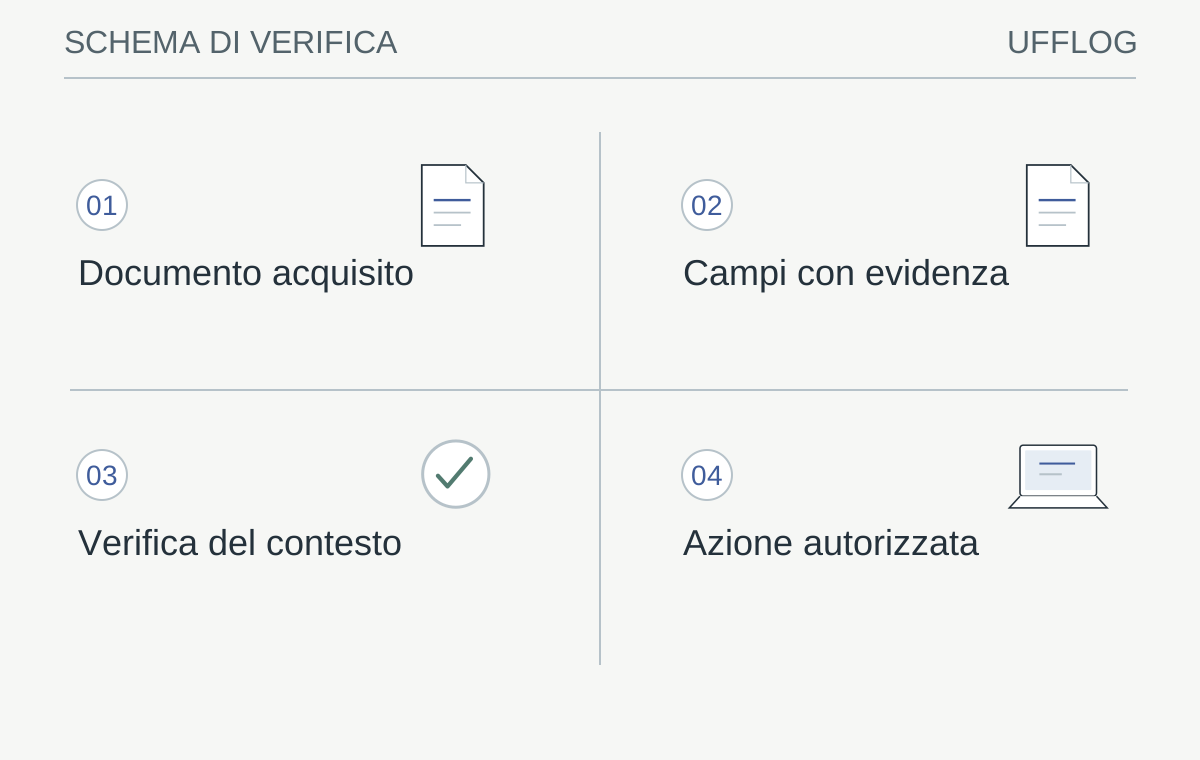
Ogni campo conserva la propria evidenza e attraversa controlli distinti prima di produrre effetti nel sistema aziendale.
Leggi lo schema
- Documento acquisitoPagine, qualità e identità del file
- Campi con evidenzaValore, posizione e versione dell’estrazione
- Verifica del contestoCoerenza, anagrafiche ed eccezioni
- Azione autorizzataRegistrazione dopo i controlli previsti
La verifica: Campo, contesto e autorizzazione sono sufficienti per l’effetto previsto?
Se no, invia alla revisione con originale e motivo del blocco.
Definire controlli per campo e per relazione
Un campo può essere corretto isolatamente e incoerente con il resto del documento. Per questo la verifica deve operare su più livelli. Il formato controlla se un valore è interpretabile; la relazione verifica se i valori stanno insieme; il confronto con fonti autorizzate valuta se l’identità o il riferimento corrispondano al processo aziendale. Una coordinata bancaria leggibile, per esempio, non dimostra che sia quella autorizzata per il pagamento.
In uno scenario didattico, imponibile di 1.000 euro, imposta di 220 e totale di 1.220 sono aritmeticamente coerenti. Il controllo non conferma però correttezza fiscale, prestazione ricevuta o autorizzazione alla spesa. Se il totale estratto fosse 1.280, il sistema dovrebbe segnalare la differenza senza scegliere arbitrariamente quale dato cambiare. La revisione deve poter distinguere un errore OCR da una diversa voce del documento non ancora acquisita.
I controlli sulle date richiedono la stessa attenzione. Una data formalmente valida può essere associata al campo sbagliato, come consegna invece di emissione. Un identificativo può conservare zeri iniziali che non devono essere persi trattandolo come numero. Una sigla può appartenere a un codice prodotto, non a una persona. Nel pilota elenca i campi decisivi e descrivi quali normalizzazioni sono consentite per ciascuno.
Microsoft distingue accuratezza e confidence e invita a valutare il modello sui documenti rilevanti. [1] La conseguenza pratica è usare la confidence come un segnale da calibrare insieme agli altri controlli. La guida alla verifica dei campi OCR approfondisce il collaudo dei singoli campi; qui il punto centrale è mantenere il confine fra estrazione e decisione.
Progettare la coda di revisione come un posto di lavoro
Una coda utile mostra il motivo per cui la pratica si è fermata. «Errore AI» è troppo generico: il revisore deve sapere se manca una pagina, se due valori non coincidono o se un riferimento non è presente nell’anagrafica autorizzata. Le categorie di eccezione permettono di instradare il lavoro alla persona giusta e di capire quali problemi ricorrono. Il tecnico della scansione e il responsabile amministrativo non risolvono la stessa anomalia.
Presenta originale e proposta nello stesso contesto, con i campi contestati evidenziati. Il revisore deve poter accettare, correggere o rifiutare, senza essere costretto a ricostruire l’intero documento. La correzione dovrebbe produrre una nuova versione dell’oggetto strutturato, con un esito leggibile. Non riutilizzare automaticamente una vecchia approvazione se la rielaborazione cambia un campo decisivo.
Definisci chi prende in carico le pratiche rimaste ferme e come si gestisce l’assenza del referente. L’automazione può rendere veloce il percorso standard mentre accumula eccezioni invisibili. Misura età della coda, motivi di blocco e tempo di correzione oltre al numero di documenti elaborati. Un aumento delle pratiche processate può essere controbilanciato da una crescita del lavoro residuo che emerge soltanto a fine mese.
Per dati riservati, limita ciò che il revisore può vedere al suo compito. Anche anteprime, esportazioni e schermate di diagnosi possono contenere informazioni sensibili. Non usare documenti di clienti reali come esempi pubblici o come dati di collaudo senza una base autorizzata. Il percorso di riduzione dei dati prima dell’AI aiuta a preparare campioni utili senza trasmettere tutto il contesto originale.
Scrivere nei sistemi richiede un confine ulteriore
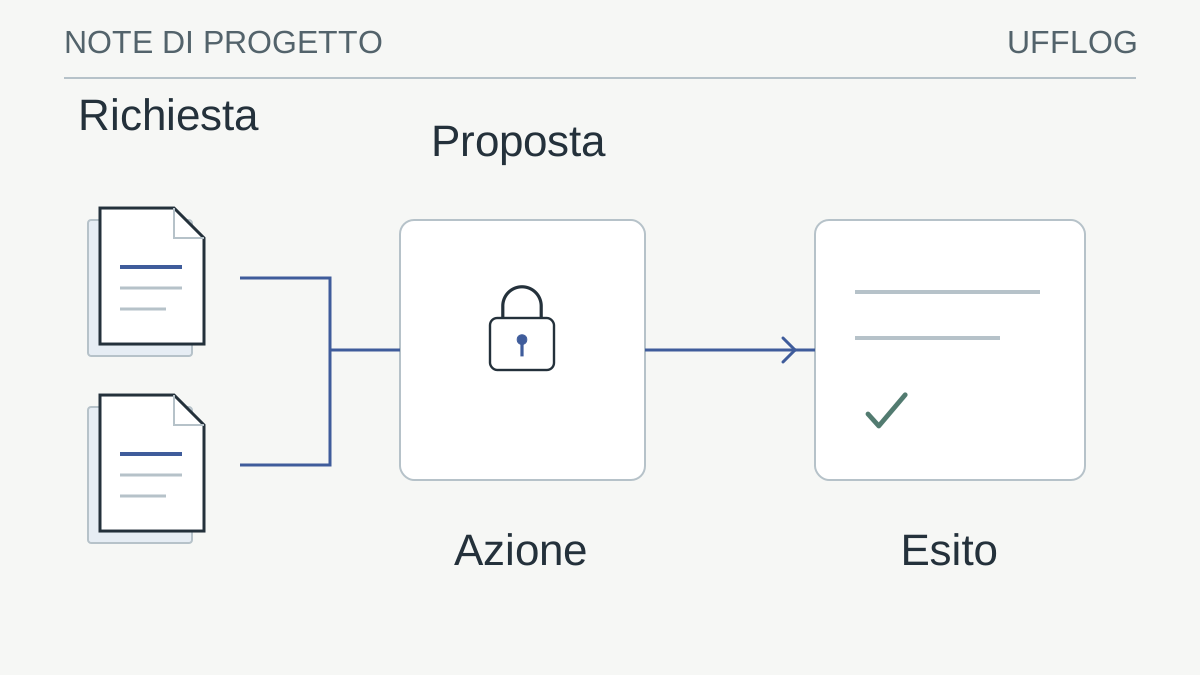
OWASP descrive i rischi di capacità e permessi eccessivi negli agenti. [3] Un componente che estrae dati non dovrebbe possedere automaticamente credenziali per modificare ogni applicazione aziendale. Il passaggio alla scrittura va delimitato per operazione, dati e destinatario, con approvazioni quando necessarie e controlli anche al di fuori del modello.
È utile prevedere una bozza prima della registrazione definitiva. Il sistema propone valori e riferimenti, una persona autorizzata verifica, e l’azione viene eseguita secondo una procedura tracciabile. Quando il pilota dimostra sufficiente affidabilità su casi delimitati, alcune attività possono essere automatizzate ulteriormente senza estendere indiscriminatamente i permessi.
Misurare gli errori che raggiungono il sistema successivo
Un test dell’estrazione può contare campi letti correttamente, ma il rischio operativo dipende anche dagli errori accettati dal flusso. Distingui un valore sbagliato fermato in revisione da un valore sbagliato registrato come valido. Nel primo caso il controllo ha intercettato il problema; nel secondo il difetto attraversa il confine e può richiedere una correzione nel gestionale. Valutare entrambi come semplici «errori OCR» nasconde la differenza di conseguenze.
Prepara un campione rappresentativo con risultati attesi verificati da persone competenti. Includi documenti puliti, scansioni difficili, formati poco frequenti e casi in cui il sistema deve astenersi. Non ricavare il risultato atteso dallo stesso modello che stai valutando. Tieni separati esempi usati per migliorare il flusso ed esempi riservati al controllo finale, così la familiarità con il campione non viene scambiata per capacità generale.
La scelta di automatizzare un campo dipende dal suo ruolo. Per una descrizione interna potrebbe bastare una revisione a campione; per un dato che avvia un pagamento o modifica un destinatario occorrono controlli e responsabilità coerenti con l’effetto. Non esiste una singola soglia di confidence che risolva tutti i casi. Il quadro NIST richiama una gestione del rischio continua, con misure collegate al contesto d’uso. [2]
Il pilota si conclude con un elenco di famiglie documentali ammesse, campi automatizzabili, eccezioni e verifiche periodiche. Un nuovo layout o un cambio del modello richiedono un confronto con quel riferimento. La qualità del sistema emerge quando può spiegare perché un dato è stato accettato, da quale evidenza proviene e chi ha autorizzato il passaggio all’azione.
Dalla guida a una verifica concreta.
Usa una fattura inventata con due aliquote, una nota di credito e un totale ambiguo. Definisci quali controlli bloccano l’importazione e quali chiedono conferma; il dato estratto deve essere verificabile sul documento di partenza.
Risorse utili e progetti ufficiali
- Tesseract — Image quality
Documentazione pubblica. Indicazioni sul rapporto tra qualità della scansione e riconoscimento del testo.
- Pydantic
Progetto open source. Validazione strutturale dei dati; un campo formalmente valido può comunque contenere un valore errato.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Microsoft — Accuracy and confidence in Document Intelligence ↗learn.microsoft.com
- NIST — AI Risk Management Framework ↗nist.gov
- OWASP — Excessive Agency ↗genai.owasp.org
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.