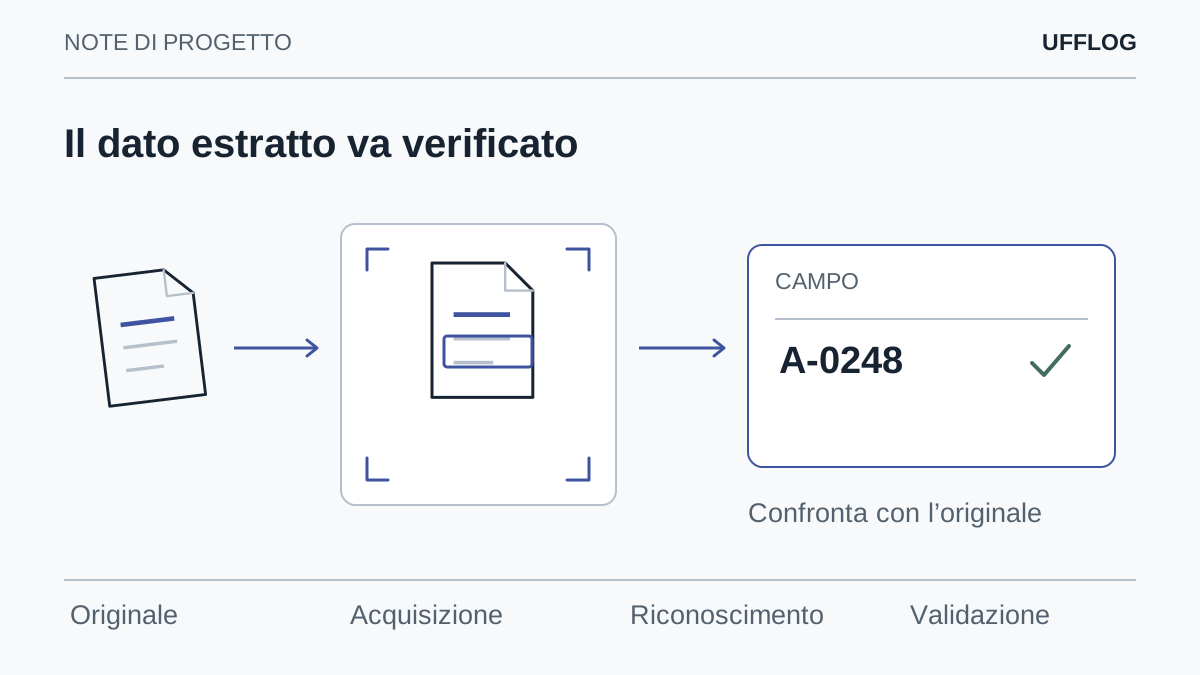
Un campo estratto da una fattura può sembrare plausibile e restare sbagliato. Uno zero letto come lettera, una virgola spostata o un totale associato alla tabella errata possono propagarsi nel gestionale. La verifica deve considerare il singolo campo, il documento originale e la conseguenza dell’errore. La confidence del modello è un segnale da valutare, non un’approvazione contabile. [1]
Scegliere pochi campi con conseguenze riconoscibili
Il collaudo non deve iniziare da «leggere tutto». Scegli una famiglia documentale e i campi che servono al passaggio successivo: per esempio identificativo del documento, fornitore, data, imponibile e totale. Per ciascuno scrivi tipo atteso, obbligatorietà, regola di normalizzazione e conseguenza di un errore. Questa scheda impedisce di valutare allo stesso modo un refuso descrittivo e un dato che modifica una registrazione economica.
Un identificativo va spesso trattato come testo, anche quando contiene soltanto cifre: gli zeri iniziali possono avere significato. Un importo richiede valuta e convenzioni di separazione; una data richiede interpretazione coerente con il documento. Un campo facoltativo assente non è equivalente a un campo obbligatorio non riconosciuto. Il risultato deve rappresentare esplicitamente assenza, dubbio e valore estratto, evitando che una stringa vuota venga trasformata in uno zero significativo.
Definisci anche come gestire più candidati. In una fattura possono comparire numero d’ordine, numero del documento e riferimenti a una precedente nota. L’OCR può leggere bene tutte le stringhe e associare quella sbagliata al campo richiesto. Il collaudo deve quindi verificare ruolo e provenienza, non soltanto corrispondenza dei caratteri. La guida generale su estrazione documentale e autorizzazione chiarisce perché un valore riconosciuto non autorizza da solo l’azione successiva.
Riconoscere il confine del documento dentro un lotto
Prima dei campi viene il documento. Una scansione può contenere due fatture consecutive, un allegato, una pagina duplicata o un foglio fuori ordine. Il sistema potrebbe leggere correttamente ogni riga e associare un totale al documento sbagliato. Prepara quindi casi sintetici che verifichino separazione, ordine e appartenenza delle pagine, senza presumere che un file corrisponda sempre a una pratica.
Assegna un identificativo al lotto e uno a ciascun documento riconosciuto. Conserva la relazione con le pagine di origine, così il revisore può ricostruire il contesto. Una divisione corretta è parte del risultato e deve precedere l’invio dei campi al gestionale. Se il confine è incerto, il lotto deve entrare in revisione anziché produrre automaticamente record separati.
Confronta anche acquisizioni dello stesso campione ottenute con impostazioni diverse, quando il flusso usa scanner o multifunzione. Il confronto serve a capire se la qualità richiesta sia sostenibile nell’uso quotidiano. Non migliorare manualmente ogni immagine del test senza registrarlo: misureresti un processo assistito diverso da quello che verrà distribuito agli utenti.
Il verbale deve indicare quali formati e combinazioni di pagine sono ammessi. Un risultato valido su documenti singoli ben separati non copre automaticamente fascicoli misti. Questa delimitazione consente di introdurre l’automazione su un caso realmente controllato e di ampliare il perimetro solo dopo una prova specifica.
Preparare una verità di riferimento indipendente
Il campione deve avere risultati attesi controllati prima della prova. Una persona competente legge il documento originale e registra i valori secondo la scheda dei campi. Per i dati più importanti può servire un secondo controllo o una risoluzione esplicita dei disaccordi. Se il riferimento è sbagliato, il test premia il risultato errato e penalizza quello corretto, producendo numeri formalmente precisi ma poco utili.
Non usare l’output dello stesso modello come verità di riferimento. Può aiutare a preparare una bozza di annotazione, ma la conferma deve essere indipendente. Conserva documento, versione dell’annotazione e regole di confronto. Se decidi di ignorare spazi o differenze di formato, scrivi esattamente quali trasformazioni sono ammesse e applicale sia al riferimento sia al risultato, senza correggere a posteriori soltanto gli errori che abbassano il punteggio.
Includi esempi frequenti e casi difficili pertinenti: scansione inclinata, contrasto basso, tabella su due pagine, importi con separatori diversi, campi assenti e allegati non appartenenti alla stessa pratica. Non occorre inventare immagini irrealistiche per mettere in crisi il sistema. Serve rappresentare le variazioni che il processo può realmente incontrare. Se usi documenti sintetici, dichiaralo; se usi campioni aziendali, devono essere autorizzati e trattati nel perimetro previsto.
Misurare errori per campo e per documento
Un unico valore di accuratezza nasconde differenze importanti. Calcola separatamente quanti campi obbligatori vengono trovati, quanti valori estratti sono corretti e quante pratiche complete rispettano tutti i criteri necessari. Un sistema può leggere bene quasi tutti i caratteri e fallire proprio sul campo che decide l’instradamento. La metrica deve seguire il lavoro, non soltanto la quantità di testo riconosciuto.
Esempio illustrativo: su cento documenti di prova, novanta hanno tutti i cinque campi necessari corretti; gli altri dieci hanno almeno un errore. Anche se il conteggio dei singoli campi appare elevato, il percorso completamente automatico non può essere descritto come corretto su tutti i documenti. Se gli errori sono intercettati in revisione, il risultato operativo è diverso rispetto a dieci registrazioni errate accettate dal gestionale. Conta quindi anche gli errori che attraversano i controlli.
Separa inoltre falsi allarmi e mancate intercettazioni. Bloccare un documento corretto costa tempo di revisione; accettarne uno sbagliato può generare conseguenze maggiori. Le due categorie possono avere pesi diversi nel processo. Microsoft presenta confidence e accuratezza come elementi da valutare, non come quantità intercambiabili. [1] Non leggere una confidence come probabilità universale di correttezza del singolo campo senza una calibrazione sul tuo campione e sul tuo uso.
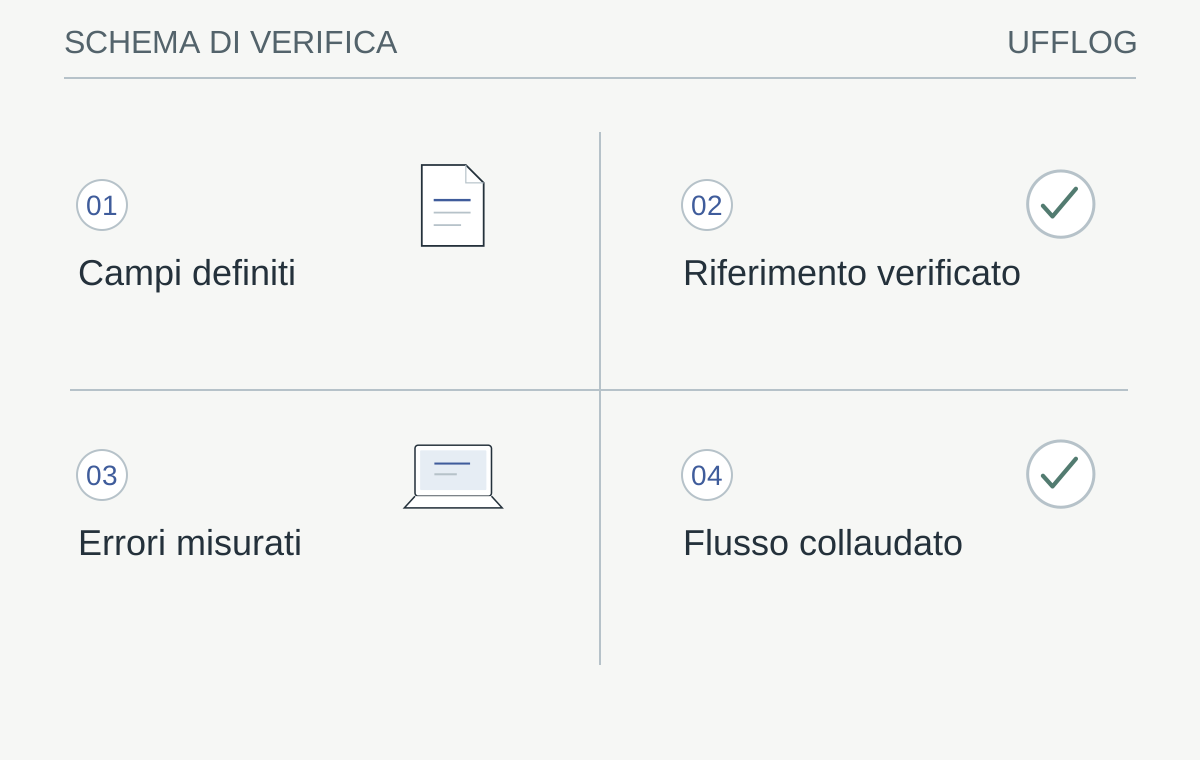
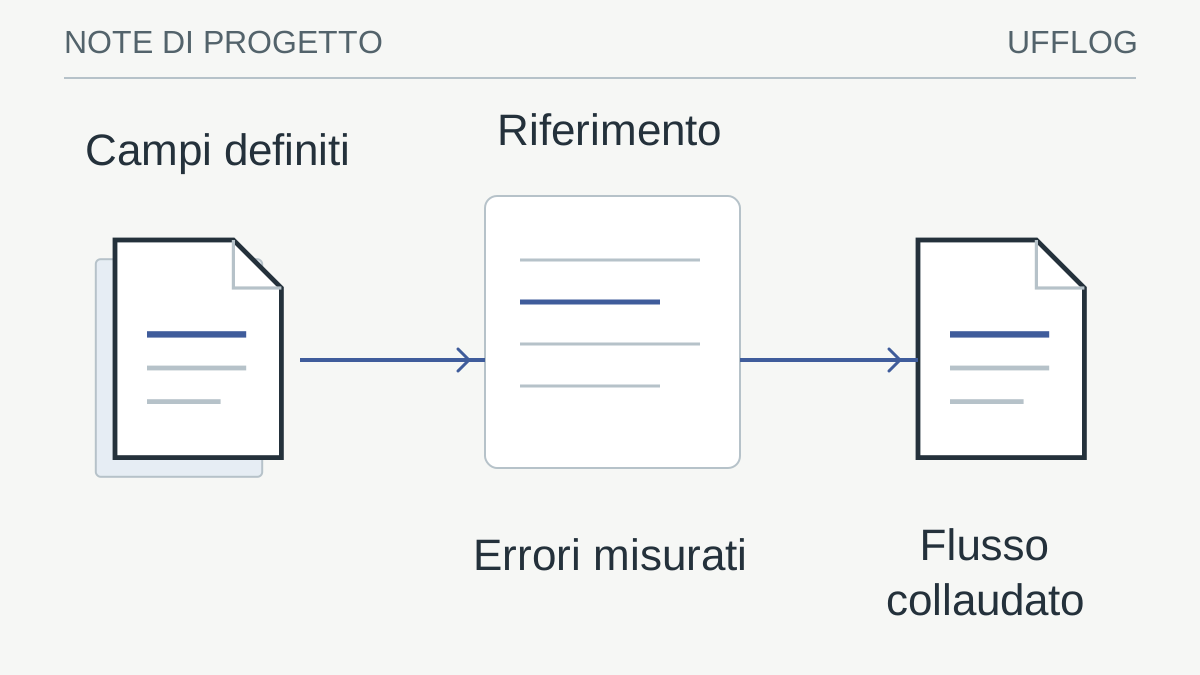
Il confronto usa un riferimento indipendente e distingue accuratezza dell’estrazione, regole del processo ed effetto nel gestionale.
Leggi lo schema
- Campi definitiTipo, unità, obbligatorietà e conseguenza
- Riferimento verificatoOriginale letto e annotato indipendentemente
- Errori misuratiPer campo, pratica e accettazione errata
- Flusso collaudatoRevisione e integrazione su dati sintetici
La verifica: Il valore è corretto, coerente e accettabile per il passaggio successivo?
Se no, ferma il campo o la pratica con evidenza e motivo di revisione.
Calibrare la revisione senza una soglia universale
Una soglia può essere utile se deriva da prove sul campo interessato. Confronta risultati corretti e scorretti in fasce di confidence, osservando quali errori vengono accettati e quante pratiche corrette finiscono in revisione. La scelta dipende dall’effetto del campo e dal lavoro che l’azienda può sostenere. Una soglia adottata per la descrizione di una merce non va trasferita automaticamente a un riferimento di pagamento.
La confidence non è l’unico segnale. Aggiungi regole deterministiche: formato, campo obbligatorio, coerenza aritmetica e confronto con anagrafiche autorizzate quando pertinente. Una discrepanza deve generare un motivo leggibile, non una correzione inventata. Se imponibile, imposta e totale non coincidono secondo le regole previste, il sistema può segnalare la differenza; non deve scegliere quale numero riscrivere per far tornare il conto.
Per il revisore mostra il punto del documento che sostiene il campo, il valore proposto e il motivo della verifica. I riferimenti Microsoft sul grounding e sulla revisione umana illustrano il valore di collegare l’estrazione all’evidenza. [2] L’interfaccia dovrebbe permettere una correzione circoscritta senza nascondere il resto della pagina. Se il campo viene modificato, registra una nuova versione dell’oggetto strutturato e conserva la distinzione fra valore del modello e valore accettato.
Provare il confine con il gestionale usando dati sintetici
Il test dell’OCR e quello dell’integrazione sono collegati ma distinti. Dopo aver verificato l’estrazione, controlla come il sistema successivo interpreta tipi, unità e campi mancanti. Un importo corretto può diventare sbagliato se il separatore decimale viene gestito male; un codice con zeri iniziali può essere abbreviato da una conversione numerica; una data può essere scambiata fra giorno e mese. Questi errori non si vedono guardando soltanto la schermata del motore OCR.
Utilizza un ambiente di prova e oggetti sintetici. Verifica la registrazione proposta prima dell’effetto definitivo, poi confronta lo stato ottenuto con il riferimento. Se la connessione cade dopo l’invio, l’integrazione deve poter accertare se la pratica esista già. Il tema dei webhook e delle richieste duplicate vale anche qui: una scansione ripetuta o una risposta persa non deve creare due documenti aziendali identici.
Il controllo qualità CSV può aiutare a individuare anomalie in un’esportazione sintetica di risultati, mentre il formatter JSON rende leggibili gli oggetti di prova. Nessuno dei due verifica il documento originale o autorizza registrazioni. Il risultato del collaudo deve includere il passaggio applicativo effettivo, perché una tabella estratta correttamente non dimostra da sola che l’intero flusso conservi il significato dei dati.
Dimensionare la coda di revisione prima dell’automatismo
La qualità non dipende soltanto dal numero di errori del modello: dipende anche dalla possibilità di verificare le pratiche sospese. Stima quanti documenti arrivano, quante revisioni vengono richieste e quanto tempo serve per ciascuna. Usa misure sul campione e separa casi semplici da quelli che richiedono ricerca o confronto con il fornitore. Non attribuire a ogni documento lo stesso costo umano.
In un esempio ipotetico, duecento documenti al giorno con un quarto da rivedere producono cinquanta revisioni. Se una revisione richiede mediamente due minuti nel campione, il solo lavoro ordinario vale cento minuti, a cui aggiungere casi complessi e coordinamento. L’esempio non prevede la produttività reale: mostra quale domanda fare prima di promettere un flusso quasi autonomo.
Definisci chi gestisce l’accumulo e come viene data priorità alle pratiche. La pressione della coda non dovrebbe indurre ad abbassare indiscriminatamente i controlli sui campi importanti. Può invece suggerire una migliore acquisizione, una famiglia documentale più ristretta o un intervento sul formato dei dati.
Misura infine gli errori introdotti durante la correzione umana. Un’interfaccia che mostra male la provenienza o rende difficile modificare una sola riga può spostare il problema dal modello all’operatore. Il collaudo deve valutare il risultato accettato dal processo, non soltanto la prima estrazione.
Definire quando fermare, correggere e ripetere il collaudo
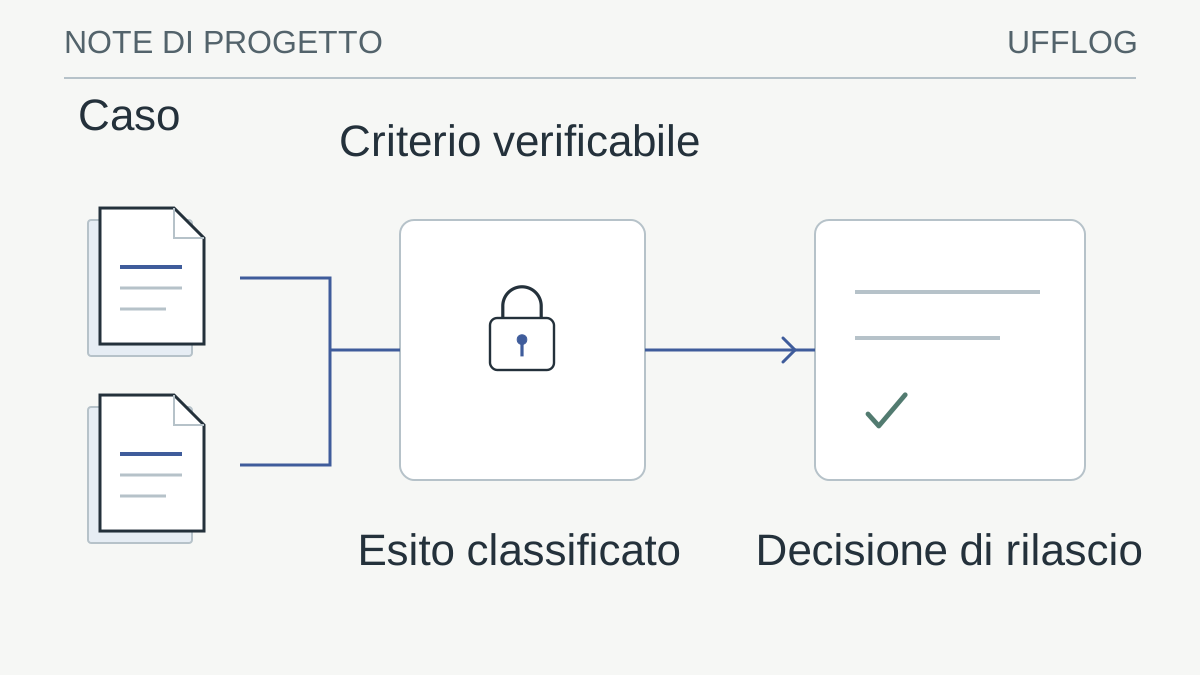
Il rilascio dovrebbe avere criteri scritti: famiglie documentali ammesse, campi richiesti, regole di revisione, soggetti responsabili e condizioni di arresto. Un nuovo layout può essere instradato inizialmente a revisione anche se il motore produce valori plausibili. Un aumento degli errori su un campo decisivo deve generare un’indagine, non soltanto un abbassamento della soglia per rendere la coda più corta.
Conserva un insieme di test stabile per confrontare cambi del modello, del prompt, dell’acquisizione o delle regole di normalizzazione. Aggiungi progressivamente i casi reali problematici dopo averli resi utilizzabili nel perimetro autorizzato. Tieni separati gli esempi con cui ottimizzi il sistema da quelli usati per valutarlo, per evitare che la familiarità con i documenti venga scambiata per affidabilità generale.
La consegna comprende campione, riferimento, risultati per campo, errori accettati, carico di revisione e problemi ancora aperti. Il responsabile può così decidere dove automatizzare e dove mantenere il controllo umano. Se il processo richiede una precisione non raggiunta, il risultato utile del test è averlo dimostrato prima dell’uso operativo. L’AI documentale diventa affidabile attraverso queste evidenze, non attraverso il solo aspetto ordinato dell’output.
Dalla guida a una verifica concreta.
Usa campi sintetici con separatori decimali, zeri iniziali e date ambigue. Definisci tipi e controlli incrociati prima dell’importazione; uno schema può bloccare un formato errato ma non conferma da solo l’esattezza del dato letto.
Risorse utili e progetti ufficiali
- Pydantic
Progetto open source. Validazione strutturale dei dati; un campo formalmente valido può comunque contenere un valore errato.
- JSON Schema — First schema
Documentazione pubblica. Un vocabolario per dichiarare tipi, campi e vincoli: diverso dalla semplice formattazione JSON.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Microsoft — Accuratezza e confidence dei campi estratti ↗learn.microsoft.com
- Microsoft — Confidence, evidenze e revisione dei documenti ↗devblogs.microsoft.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.