La manutenzione IT diventa utile quando cambia ciò che l’azienda può sapere dei propri sistemi. Il risultato non è un elenco di operazioni eseguite: è poter distinguere un servizio verificato, una dipendenza fragile e un problema ancora aperto. In una PMI questa differenza conta perché le stesse persone seguono spesso postazioni, server, stampa, accessi e backup. Un piano leggibile evita che ciò che funziona oggi venga dato per scontato anche domani.
Questa guida propone un metodo da adattare al perimetro effettivo, con esempi illustrativi e controlli prevalentemente osservativi. Le modifiche su sistemi produttivi richiedono autorizzazione, procedure del produttore e una possibilità di recupero verificata. Un controllo remoto non sostituisce automaticamente un intervento fisico, una valutazione specialistica o un’attività contrattualmente esclusa.
1. Parti dai servizi che devono continuare a funzionare
Un inventario di dispositivi è necessario, ma non descrive da solo il lavoro. Una scansione verso cartella può dipendere da multifunzione, rete, identità, server e autorizzazioni. La fatturazione può richiedere un gestionale locale, un database, un certificato e un collegamento esterno. Scrivi prima il nome del servizio e chi lo usa, poi collega i componenti che lo rendono possibile. Avrai così un criterio per decidere cosa provare dopo ogni intervento.
Per ciascun servizio indica un referente operativo, un referente tecnico, gli orari sensibili e una conseguenza concreta del fermo. Una frase come «l’amministrazione deve registrare e consultare i documenti della giornata» è più utile di «server importante». Permette di preparare una prova rappresentativa e di riconoscere una ripartenza soltanto parziale, per esempio quando l’applicazione si apre ma non riesce a salvare.
2. Separa controllo ricorrente, cambiamento e incidente
Tre attività possono comparire nello stesso strumento di gestione, ma hanno obiettivi diversi. Il controllo ricorrente osserva uno stato e lo confronta con un criterio. Il cambiamento modifica una configurazione o una versione. L’incidente richiede di contenere un impatto e recuperare un servizio. Se ogni avviso diventa automaticamente una modifica, il piano perde prevedibilità; se ogni modifica viene trattata come routine, possono sparire autorizzazioni e verifiche necessarie.
Definisci quindi quali azioni il servizio gestito può eseguire autonomamente, quali richiedono una finestra concordata e quali devono fermarsi in attesa di una decisione. Riavviare una postazione inattiva e riavviare il server di produzione non sono la stessa operazione. Anche quando un’automazione propone entrambi i comandi, il contesto operativo deve governare la scelta e lasciare un esito verificabile.
3. Costruisci una cadenza basata sulle conseguenze
La frequenza non deve essere uguale per tutto. Un esito di backup, lo stato di una protezione endpoint e una scadenza contrattuale hanno tempi diversi. Organizza controlli frequenti sui segnali che richiedono risposta rapida, revisioni periodiche sulle tendenze e verifiche dopo i cambiamenti. Un aggiornamento del sistema di stampa, per esempio, può rendere necessaria una prova del flusso documentale anche se il controllo previsto dal calendario era già stato completato.
Una matrice semplice contiene quattro campi: cosa osservare, quando, quale risultato è accettabile e chi interviene se manca. Evita formule come «verificare tutto ogni settimana»: non indicano una procedura né un limite. Per un volume storage puoi registrare crescita, spazio disponibile e capacità necessaria alle operazioni previste. La soglia va collegata al tempo richiesto per intervenire, non soltanto a una percentuale uguale per ogni disco.
4. Tratta le patch come un processo completo
Il NIST descrive il patch management come un processo che comprende identificazione, priorità, acquisizione, installazione e verifica. Questa impostazione aiuta a evitare una scorciatoia comune: considerare concluso l’intervento quando la console comunica che il pacchetto è stato distribuito. La distribuzione è una fase; il servizio deve ancora dimostrare di funzionare nella configurazione risultante.
Prima di intervenire raccogli versione attuale, compatibilità dichiarata, eventuale riavvio e dipendenze coinvolte. Prepara un gruppo limitato ma rappresentativo: una macchina senza applicazioni aziendali può aggiornarsi perfettamente e non dire nulla sul gestionale. Per i sistemi Windows, la distribuzione per gruppi consente di organizzare un avanzamento progressivo. I criteri di passaggio restano da definire per il tuo ambiente.
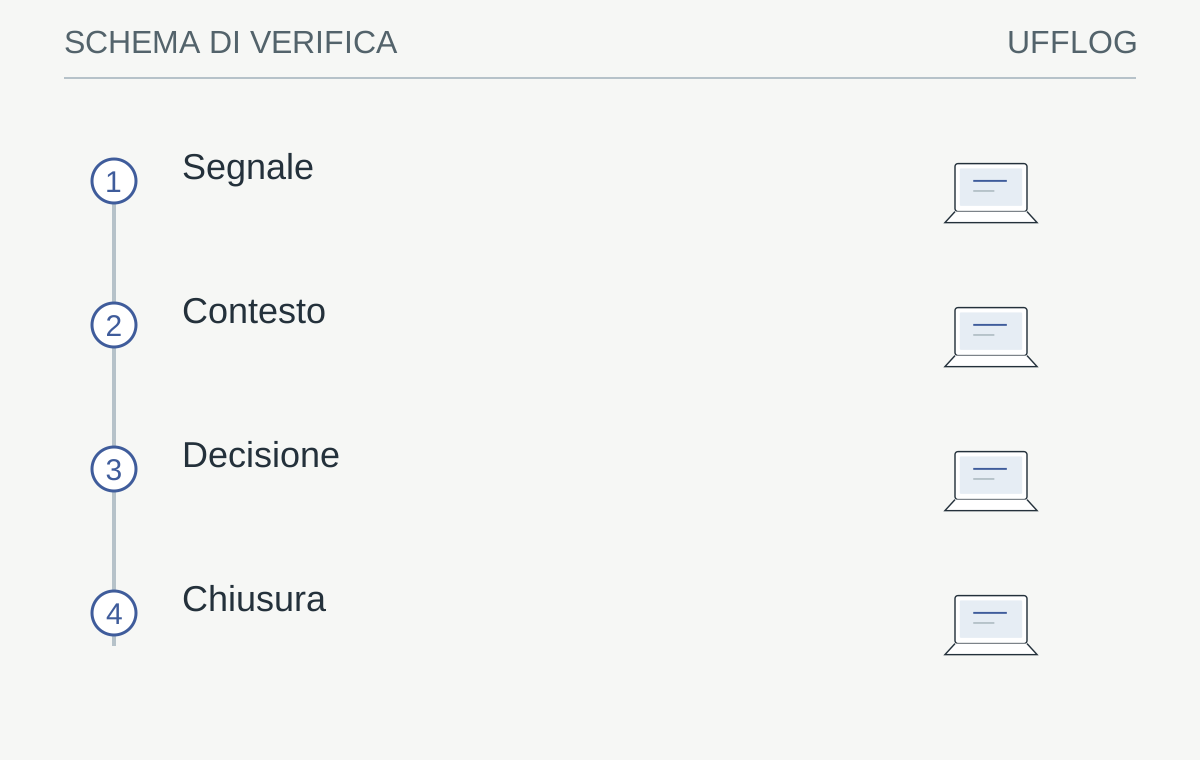
Schema originale: un avviso utile produce una decisione tracciabile, oppure un’incertezza dichiarata da risolvere.
Leggi lo schema
- SegnaleEvento con orario e sistema
- ContestoConseguenza e dipendenze
- DecisioneAzione, titolare e scadenza
- ChiusuraEsito, limiti e prossimo controllo
La verifica: L’eccezione ha una scadenza e un responsabile?
Un avviso silenziato può lasciare aperto il rischio
5. Raccogli prove brevi, ripetibili e pertinenti
Una prova utile ha un ingresso riconoscibile e un risultato osservabile. Dopo una modifica alla scansione, puoi utilizzare un documento di test privo di dati personali e verificare destinazione, leggibilità, nome file e permessi. Dopo l’aggiornamento di una postazione, puoi controllare l’avvio dell’applicazione critica e un’operazione consentita in ambiente di prova. Documenta ciò che hai effettivamente verificato, senza estendere la conclusione a funzioni non esercitate.
Non serve conservare schermate di ogni clic. Serve un legame tra intervento ed evidenza: identificativo della richiesta, sistema, risultato atteso, risultato ottenuto e limite della prova. Se l’operatore non dispone dell’account applicativo necessario, la chiusura può restare in attesa della conferma del referente. Scrivere «nessuna segnalazione ricevuta» non equivale a dimostrare che l’attività aziendale sia riuscita.
6. Collega protezione, backup e possibilità di recupero
Nel piano di manutenzione, l’assenza di errori di backup è un segnale da leggere insieme al resto. Controlla che i sistemi previsti compaiano nel perimetro, che i punti di recupero siano coerenti con gli obiettivi e che le anomalie abbiano una gestione. Dopo una nuova applicazione, un cambio di identità o un trasferimento dei dati, chiediti se il piano protegge ancora ciò che l’azienda considera essenziale.
Inserisci prove di ripristino concordate, con dati e destinazioni adatti al test. Il controllo del job e il recupero applicativo rispondono a domande diverse. La manutenzione può verificare che il processo sia presente e seguito; una prova completa può richiedere tempo, isolamento e responsabilità specifiche. Approfondisci questa distinzione nella guida su replica, immutabilità e scenari di guasto, prima di attribuire al solo monitoring una garanzia di continuità.
7. Gestisci le eccezioni senza trasformarle in dimenticanze
Un sistema può non essere aggiornabile subito perché dipende da un’applicazione non ancora compatibile. L’eccezione deve descrivere il motivo, l’esposizione residua, una misura temporanea sostenibile e il momento della nuova verifica. Una riga che dice «non aggiornare» lascia il problema senza proprietario. Una riga con responsabile e scadenza rende visibile una decisione e permette di rivalutarla quando cambia il contesto.
Non aggirare automaticamente i blocchi di compatibilità. Microsoft documenta meccanismi di salvaguardia per alcune distribuzioni di aggiornamenti: la loro presenza richiede comprensione della causa, non un automatismo per rimuoverli. Nel report separa le macchine regolarmente aggiornate da quelle escluse e spiega la ragione. Una percentuale complessiva molto alta può nascondere proprio il sistema più esposto o più difficile da recuperare.
8. Usa log e statistiche per decidere, non per riempire il report
Un numero diventa utile quando ha una definizione. «Quaranta avvisi» non distingue duplicati, problemi già risolti e nuovi impatti. «Tre servizi senza evidenza di controllo nei tempi previsti» orienta invece una verifica. Scegli poche metriche coerenti: copertura del perimetro, aggiornamenti fuori policy, esiti di prova mancanti, eccezioni scadute e tempo necessario a chiudere le anomalie confermate. Mantieni separati i dati misurati dalle stime.
Per esplorare un log già autorizzato puoi usare Log Lens, che aiuta a riconoscere ricorrenze sul dispositivo. Il tool non conosce automaticamente l’architettura e non decide quale evento sia un incidente. Prima di condividere estratti, rimuovi credenziali, token e dettagli non necessari; conserva la fonte originale nel sistema previsto dall’organizzazione. Un riepilogo senza intervallo temporale o contesto può suggerire una conclusione sbagliata.
9. Prepara un report che conduca alla prossima azione
Un buon report periodico può essere breve e preciso. Parti da ciò che è cambiato per il lavoro: interventi conclusi con prova, problemi aperti con impatto, decisioni richieste e attività previste. Aggiungi il dettaglio tecnico in una sezione separata, collegata alle evidenze. In questo modo chi gestisce l’azienda comprende le priorità e chi segue i sistemi trova le informazioni necessarie per verificare il ragionamento.
Considera uno scenario illustrativo: il backup di una macchina virtuale è regolare, ma la prova del gestionale fallisce perché manca una dipendenza di rete. Il report deve dichiarare entrambi i fatti. La decisione successiva può essere correggere il perimetro del test e ripeterlo, senza chiamare riuscito il recupero applicativo. Questo modo di scrivere rende il servizio più trasparente anche quando il risultato evidenzia un limite.
Un altro esempio riguarda una coda di stampa che smette di crescere dopo un riavvio. L’intervento sembra riuscito, ma prima di chiuderlo occorre distinguere lo smaltimento dei documenti dalla loro cancellazione. Una prova concordata con un file sintetico permette di osservare il passaggio dalla postazione al dispositivo e di evitare di usare documenti reali come materiale diagnostico. Se il problema ricompare, la sequenza di eventi raccolta rende possibile approfondire driver, rete o autenticazione senza ripartire da ipotesi generiche.
Nel confronto periodico con l’azienda, riserva spazio a ciò che il sistema di gestione non vede. Una sede che ha cambiato orari, un nuovo servizio usato senza informare il tecnico o una stampante spostata su un’altra rete possono modificare il perimetro senza produrre un errore immediato. Il dialogo con i referenti completa la telemetria: mantiene collegati i numeri ai processi effettivi e aiuta a correggere il piano prima della successiva modifica.
10. Delimita cosa il servizio comprende e quando va riprogettato
Il perimetro deve chiarire sistemi inclusi, canali di segnalazione, orari, responsabilità e attività escluse. Monitoring, gestione degli aggiornamenti, assistenza agli utenti e test di ripristino possono essere componenti distinti. Non presumere che una notifica comporti automaticamente un intervento fuori orario o che la gestione remota includa ricambi e presenza in sede. Le condizioni operative fanno parte della qualità del servizio perché determinano come si passa dal segnale all’azione.
Rivedi il piano quando entrano nuove sedi, software, volumi di stampa, identità o servizi cloud. Prima di chiedere una proposta, prepara l’elenco dei servizi essenziali, le anomalie ricorrenti e ciò che manca nel controllo attuale. Puoi partire dalla pagina servizi IT gestiti per definire un progetto iniziale e una gestione continuativa. L’obiettivo è un sistema di lavoro comprensibile, nel quale ogni controllo abbia un’utilità e ogni eccezione una strada di chiusura.
Dalla guida a una verifica concreta.
Dividi i controlli per frequenza e per conseguenza del mancato esito. Assegna proprietario, evidenza e prossimo passo a backup, spazio, aggiornamenti e certificati; una checklist completata senza riscontro tecnico è poco utile.
Risorse utili e progetti ufficiali
- Zabbix
Progetto open source. Monitoraggio da gestire e aggiornare. Software aperto non significa un servizio presidiato già incluso.
- CISA — KEV data
Dati aperti. Catalogo pubblico di vulnerabilità sfruttate: un criterio di priorità, non un inventario dei propri rischi.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- NIST — Enterprise Patch Management Planning ↗csrc.nist.gov
- Microsoft — Windows servicing strategy ↗learn.microsoft.com
- Microsoft — Safeguards for Windows deployments ↗learn.microsoft.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.