Un backup può fallire senza che nessuno intervenga, oppure non partire affatto e non produrre l’errore atteso. La verifica riguarda una catena: evento, raccolta, notifica, presa in carico e ripristino della protezione. Vedere un indirizzo email nella configurazione non dimostra che quella catena funzioni. Il risultato utile è sapere quando manca un punto atteso, chi agisce e quale evidenza consente di chiudere la segnalazione.
1. Costruisci l’elenco delle protezioni attese
Parti dalle risorse da proteggere, non soltanto dai job presenti in console. Elenca macchine, database, file o account, associandoli a prodotto, lavoro, frequenza e obiettivo. Un job completamente riuscito non descrive le sorgenti che non sono mai state incluse. La riconciliazione tra inventario e protezioni è quindi il primo controllo del monitoraggio.
Per ogni risorsa indica quale esito ti aspetti e entro quale finestra. La pianificazione nominale può richiedere un margine per durata e variazioni, ma il margine deve essere esplicito. Se ogni ritardo viene considerato normale senza un criterio, il monitoraggio non riesce a distinguere una variazione accettabile da una perdita crescente di protezione.
Registra responsabile tecnico e referente del servizio. La stessa anomalia può avere priorità diversa se riguarda un archivio secondario o il sistema che gestisce le spedizioni. Evita una classificazione basata soltanto sul colore mostrato dal prodotto: collega l’evento all’impatto sul punto di recupero e sul processo aziendale.
L’inventario deve essere aggiornato quando vengono aggiunte o rimosse sorgenti. Un controllo periodico dovrebbe cercare risorse senza copertura e job che proteggono oggetti ormai dismessi. Il primo caso è una lacuna; il secondo può produrre rumore e costi che rendono più difficile riconoscere gli eventi davvero importanti.
2. Distingui errore, avviso e assenza di esecuzione
Un fallimento segnala che un’attività avviata non ha raggiunto il risultato previsto. Un avviso può descrivere un esito parziale o una condizione da approfondire. L’assenza di esecuzione è ancora diversa: se il job non parte, potrebbe non esistere l’evento che il canale di errore si aspetta. Il progetto deve quindi osservare anche il mancato arrivo di un risultato atteso.
Aggiungi durata anomala, ritardo del punto, sorgenti saltate e crescita inconsueta quando sono pertinenti al prodotto. Non trasformare ogni variazione in un’emergenza: definisci soglie, contesto e azione associata. La guida agli alert utili aiuta a distinguere segnali su cui qualcuno può agire da notifiche che vengono soltanto accumulate.
Controlla le impostazioni globali e quelle del singolo lavoro. Veeam documenta notifiche a livello di job; il comportamento va letto insieme alla configurazione generale e alla versione in uso. [1] Un’opzione corretta in un punto può essere modificata o resa incompleta da un’altra parte della configurazione.
Mantieni visibile il significato del segnale. “Job riuscito” e “ultimo punto verificato utilizzabile” sono evidenze diverse. Il monitoraggio può confermare l’esecuzione e la presenza del risultato, mentre il recupero richiede un controllo ulteriore. Questa distinzione evita sia allarmi inutili sia rassicurazioni più ampie di ciò che il sistema ha realmente osservato.
3. Verifica il canale fino al destinatario reale
Disegna il percorso dell’evento: prodotto, eventuale collector, servizio di posta o ticketing, coda e persona responsabile. Ogni passaggio può introdurre filtri, errori o ritardi. Un messaggio accettato dal server di posta non dimostra che sia arrivato nella casella letta dal tecnico, né che il ticket sia stato assegnato correttamente.
Usa la funzione di test del prodotto o un evento sintetico previsto dall’integrazione. Non provocare guasti alle copie operative scollegando repository o cambiando credenziali. Registra ora di emissione, ricezione e assegnazione. Se il test controlla soltanto il trasporto email, dichiaralo: non prova automaticamente che ogni tipo di evento del backup venga generato.
Controlla filtri, quarantena, regole di inoltro e formati del messaggio. Le informazioni devono permettere di individuare risorsa, job e riferimento dell’evento, senza includere segreti o dettagli riservati inutili in canali condivisi. Un alert troppo generico costringe a cercare tutto da capo; uno eccessivamente dettagliato può ampliare l’esposizione dei dati.
Preferisci responsabilità di servizio gestite rispetto alla dipendenza da una casella personale non presidiata durante le assenze. Questo non impone un particolare prodotto: richiede che esista un destinatario effettivo e una sostituzione. La prova deve includere quel percorso alternativo, non soltanto l’account del tecnico che ha configurato il sistema.
4. Collauda la presa in carico e l’escalation
Dopo la ricezione, chiedi al responsabile di identificare il problema e il servizio coinvolto. Il test deve verificare se trova la console o l’evidenza pertinente, comprende la priorità e sa quale procedura seguire. Un alert consegnato ma non interpretabile non completa il controllo operativo.
Definisci chi riconosce l’evento, chi lavora sul problema e chi viene coinvolto se manca una risposta. I tempi devono essere coerenti con gli accordi e con la copertura reale del servizio. Non descrivere un canale disponibile sempre come intervento umano continuo se quella disponibilità non è prevista e organizzata.
Prepara un’escalation per indisponibilità del referente e per problemi che superano il suo perimetro. Un errore di accesso, una catena non leggibile e una capacità esaurita possono richiedere competenze diverse. L’alert dovrebbe raggiungere un processo capace di instradare il caso, non obbligare una sola persona a risolvere qualunque evento.
Usa una prova sintetica concordata e conserva esiti e tempi. Se il destinatario deve chiedere informazioni che il messaggio poteva fornire, migliora il contenuto. Se invece manca un’autorizzazione o un contatto, correggi la procedura. Il runbook di ripartenza offre un modello per associare azione, controllo e condizione di arresto anche alle attività di gestione del backup.
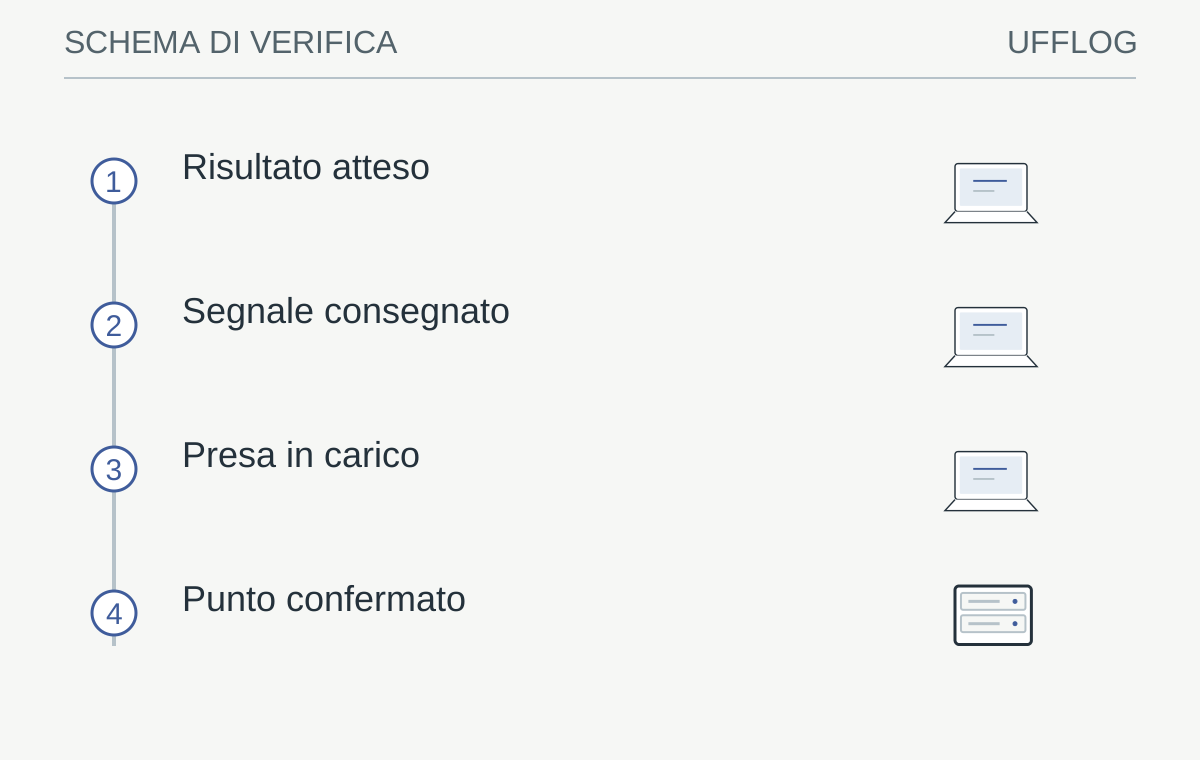
La notifica è utile se raggiunge un responsabile e si chiude su un punto di recupero verificato.
Leggi lo schema
- Risultato attesoSorgenti, finestra e mancata esecuzione osservati
- Segnale consegnatoEvento e canale verificati fino alla coda
- Presa in caricoResponsabile, priorità ed escalation reali
- Punto confermatoCopertura, ritardo e limiti dopo la correzione
La verifica: È tornato un punto utile oppure è soltanto scomparso l’allarme?
Un job mai partito può non generare la stessa notifica di un job terminato in errore.
5. Gestisci ricorrenze senza perdere il primo evento
Un problema può generare molte notifiche identiche. Raggrupparle aiuta a ridurre rumore, ma il raggruppamento deve conservare primo evento, ultime ricorrenze e risorse interessate. Se ogni nuova notifica apre un ticket separato, il lavoro si frammenta; se tutto viene nascosto dietro un unico alert silenziato, può sparire la percezione della durata del problema.
Definisci una chiave di correlazione basata su risorsa, lavoro e tipo di anomalia, secondo le capacità della piattaforma. Non raggruppare eventi soltanto perché il testo è simile: due repository differenti possono richiedere interventi distinti. Mantieni una possibilità di riapertura quando il problema ritorna dopo una chiusura verificata.
Le eccezioni temporanee devono avere motivazione, responsabile e scadenza. Un job sospeso per una manutenzione autorizzata può richiedere un trattamento diverso, ma la sospensione non deve diventare invisibile. Al termine della finestra occorre controllare che la protezione sia effettivamente ripresa, non soltanto che l’allarme sia stato riabilitato.
Log Lens può aiutare a ordinare un’esportazione ripulita e a riconoscere sequenze di eventi. Non sorveglia autonomamente la console e non sostituisce il monitoraggio continuo. Usa dati minimizzati, senza credenziali o contenuti aziendali superflui, e considera l’analisi come supporto alla lettura delle evidenze del prodotto.
6. Verifica il punto prodotto dopo la correzione
Un ritentativo verde è un segnale importante, ma la chiusura deve controllare quale punto è stato creato, per quali sorgenti e con quale ritardo. AWS Backup descrive punti di recupero associati alle risorse; il principio operativo è verificare il risultato presente, oltre al piano configurato. [2] La modalità concreta dipende dal software utilizzato.
Confronta l’ultimo punto disponibile con l’obiettivo del servizio e annota la finestra rimasta scoperta. Se un job fallisce per più cicli e poi riesce, la nuova esecuzione non ricrea automaticamente i punti mancanti nel periodo precedente. Questa informazione deve restare nel rapporto, anche quando la situazione corrente è rientrata.
Quando il problema ha coinvolto leggibilità, consistenza o catena, programma un recupero campione adeguato. Non è necessario eseguire un restore completo dopo qualsiasi avviso, ma il criterio deve essere collegato all’effetto possibile. La verifica va autorizzata e isolata, con dati e destinazioni controllati.
Registra causa, correzione, punto risultante e limiti residui. Se la causa non è stata identificata ma il job è ripartito, dichiaralo: può essere corretto chiudere una fase di urgenza mantenendo un approfondimento aperto. Evita di trasformare la scomparsa temporanea del sintomo in una spiegazione tecnica non dimostrata.
7. Controlla anche la salute del monitoraggio
Il sistema che osserva i backup può interrompersi. Prevedi un controllo sul mancato arrivo di dati attesi dal collector o dalla piattaforma, distinto dall’errore del singolo job. Se tutto il monitoraggio dipende dalla stessa infrastruttura osservata, valuta quale percorso permette di accorgersi della sua indisponibilità.
Verifica credenziali delle integrazioni, scadenze e cambi di endpoint secondo i prodotti. Non registrare segreti nei controlli o nei report. Un rinnovo di posta, un cambio di account o una nuova policy di accesso possono interrompere la consegna senza modificare i job di backup, ed è per questo che il test deve seguire la catena completa.
Riesamina destinatari e responsabilità dopo cambi di personale o fornitore. Mantieni un inventario delle integrazioni con proprietario e procedura di ripristino. La disponibilità del canale non deve dipendere da una configurazione conosciuta soltanto da chi l’ha installato.
Esegui controlli periodici proporzionati al rischio, evitando test invasivi sulla produzione. Una prova sintetica del canale, una verifica dell’assenza di esecuzione e un controllo della presa in carico coprono aspetti diversi. Conserva gli esiti separati: il successo di uno non autorizza a dichiarare collaudati automaticamente anche gli altri.
8. Riporta copertura e lacune in modo leggibile
Il rapporto di servizio dovrebbe mostrare risorse protette, esecuzioni attese e osservate, anomalie aperte, tempo di presa in carico e punti mancanti. Aggiungi prove di recupero quando eseguite, con il loro perimetro. Non ridurre tutto a una percentuale di job verdi che nasconde sorgenti escluse o finestre senza protezione.
La guida al report mensile di servizio aiuta a collegare indicatori e decisioni. Un errore ricorrente deve portare a un intervento con responsabile, non soltanto a una riga ripetuta ogni mese. Se il volume degli alert cresce, valuta qualità delle soglie e cause, invece di silenziare indiscriminatamente le notifiche.
Il controllo è completo quando l’organizzazione sa riconoscere l’assenza di un risultato, consegnare il segnale e verificare il ritorno della protezione. Non garantisce che ogni copia sia recuperabile in ogni scenario; rende però osservabili problemi che altrimenti potrebbero restare nascosti fino al momento del bisogno. Il monitoraggio sostiene le prove di restore e la gestione della capacità, formando una catena di evidenze più utile di un semplice messaggio automatico.
Dalla guida a una verifica concreta.
Prendi un errore anonimizzato e ricostruisci rilevazione, notifica, presa in carico e verifica della copia successiva. Un avviso spedito non dimostra che qualcuno lo abbia letto o che la protezione sia tornata operativa.
Risorse utili e progetti ufficiali
- Prometheus — Alertmanager
Documentazione pubblica. Raggruppamento, instradamento e soppressione degli avvisi con regole esplicite.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Veeam — Notifiche dei job ↗helpcenter.veeam.com
- AWS Backup — Punti di recupero ↗docs.aws.amazon.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.