Un rapporto mensile deve aiutare a prendere decisioni, non soltanto dimostrare che il sistema ha prodotto dati. Numero di ticket, patch e alert diventano utili quando sono collegati a perimetro, impatto e azioni. La prima domanda da fare è quali dispositivi e servizi rappresentano davvero quei numeri.
Separare la pagina decisionale dal dettaglio tecnico
La prima pagina dovrebbe dire quali servizi sono stati interessati, che cosa è cambiato e quali decisioni servono. Non deve contenere ogni evento raccolto. Il dettaglio tecnico resta disponibile in sezioni successive, con riferimenti che permettono di risalire ai dati. Questa organizzazione evita che il responsabile aziendale debba interpretare decine di grafici prima di capire se occorre approvare un intervento.
Una struttura efficace distingue risultati verificati, problemi aperti e proposte. Per ogni proposta indica beneficio atteso, vincolo attuale e prerequisiti. Non promettere che un acquisto eliminerà qualsiasi rischio; spiega quale condizione concreta dovrebbe migliorare e come verrà misurata. Se manca un’informazione necessaria alla decisione, la richiesta può essere un approfondimento, non per forza una spesa immediata.
La sintesi non deve nascondere gli elementi scomodi. Un servizio escluso dal monitoraggio, un dispositivo non raggiungibile o una prova di recupero rinviata meritano visibilità anche se non hanno generato incidenti. La differenza fra «non rilevato alcun errore» e «non abbiamo dati» deve essere evidente. Una pagina breve è utile quando conserva questa distinzione, non quando riduce ogni stato a un indicatore verde.
Leggere correttamente percentuali, medie e tempi
Verifica intervallo temporale, fuso orario, dispositivi inclusi e componenti esclusi o non comunicanti. Se il parco è cambiato, chiedi che il confronto con il mese precedente lo evidenzi. Servono l’inventario corrente e una definizione delle metriche contrattuali: «disponibile», «preso in carico» e «risolto» non sono sinonimi. Nel monitoraggio, le osservazioni interne e le prove viste dall’utente descrivono aspetti diversi del servizio. [1] Un host acceso non dimostra che il gestionale sia utilizzabile.
Ogni percentuale richiede un denominatore e un criterio di inclusione. Se novanta dispositivi risultano aggiornati su cento osservati, ma l’inventario ne contiene centoventi, il rapporto deve spiegare cosa accade agli altri venti. Non è corretto trasformare l’assenza di telemetria in conformità. Se dieci dispositivi sono stati dismessi durante il periodo, rendi leggibile il cambiamento senza confrontare automaticamente popolazioni diverse.
Anche una media può nascondere situazioni importanti. Dieci ticket risolti in pochi minuti e uno rimasto bloccato per giorni possono produrre un valore poco rappresentativo dell’esperienza dell’utente interessato. Chiedi una distribuzione o classi di durata, insieme ai casi più rilevanti. La priorità del ticket e le ore coperte dal servizio devono accompagnare i tempi, altrimenti il confronto può essere fuorviante.
Definisci l’inizio e la fine della misura. Una risposta automatica non coincide con una presa in carico tecnica; una soluzione temporanea può ripristinare il lavoro prima della correzione definitiva. Per valutare un accordo contrattuale usa la definizione effettivamente concordata, comprese esclusioni e finestre. Il rapporto operativo può offrire informazioni ulteriori, ma non deve cambiare il significato delle metriche soltanto per mostrare un risultato più favorevole.
Leggere gli esiti insieme alle eccezioni
Per aggiornamenti e protezioni cerca sistemi verificati, sistemi fuori copertura e problemi rimasti aperti. Per il backup distingui completamento dei processi da prove di recupero, specificando campione, data ed esito. Per l’assistenza separa prima risposta, ripristino del lavoro e soluzione definitiva. Le percentuali devono mostrare il denominatore: novantacinque aggiornamenti riusciti su cento previsti hanno un significato diverso da novantacinque dispositivi visibili su un parco di centoventi.
Valutare il backup senza ridurlo al numero dei job
Il numero dei processi riusciti descrive una parte della catena. Per capire la capacità di recupero servono almeno perimetro protetto, destinazioni, punti disponibili e prove eseguite. Se un nuovo database non è entrato nella configurazione, il fatto che tutti i job esistenti abbiano successo non dimostra che quel database sia coperto. Il confronto con l’inventario è quindi essenziale.
Distingui controlli di leggibilità, recupero di file e ripristino di applicazioni. Ogni prova deve dichiarare campione, ambiente, criteri di riuscita e limitazioni. Un singolo file aperto correttamente non autorizza a concludere che l’intero gestionale rientri nel tempo richiesto. La guida ai tempi reali di ripartenza aiuta a collegare il risultato tecnico all’attività aziendale.
Nel rapporto indica anche ciò che non è stato provato e la ragione. Una prova rinviata per mancanza di una finestra richiede una decisione diversa da un errore di recupero. Non sommare i due casi in una generica voce «non riuscito», ma non escluderli dal riepilogo. Per gli errori ripetuti dei job, la guida alle notifiche di backup chiarisce come collegare avvisi, responsabili e verifiche effettive.
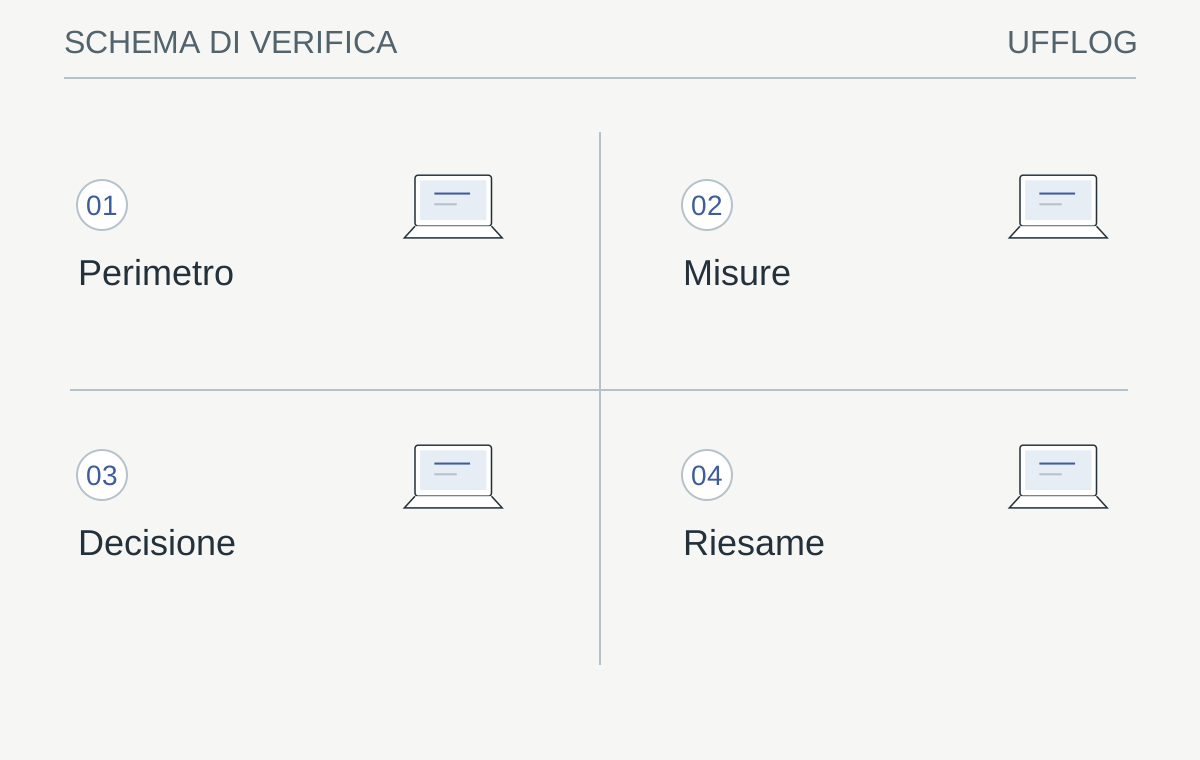
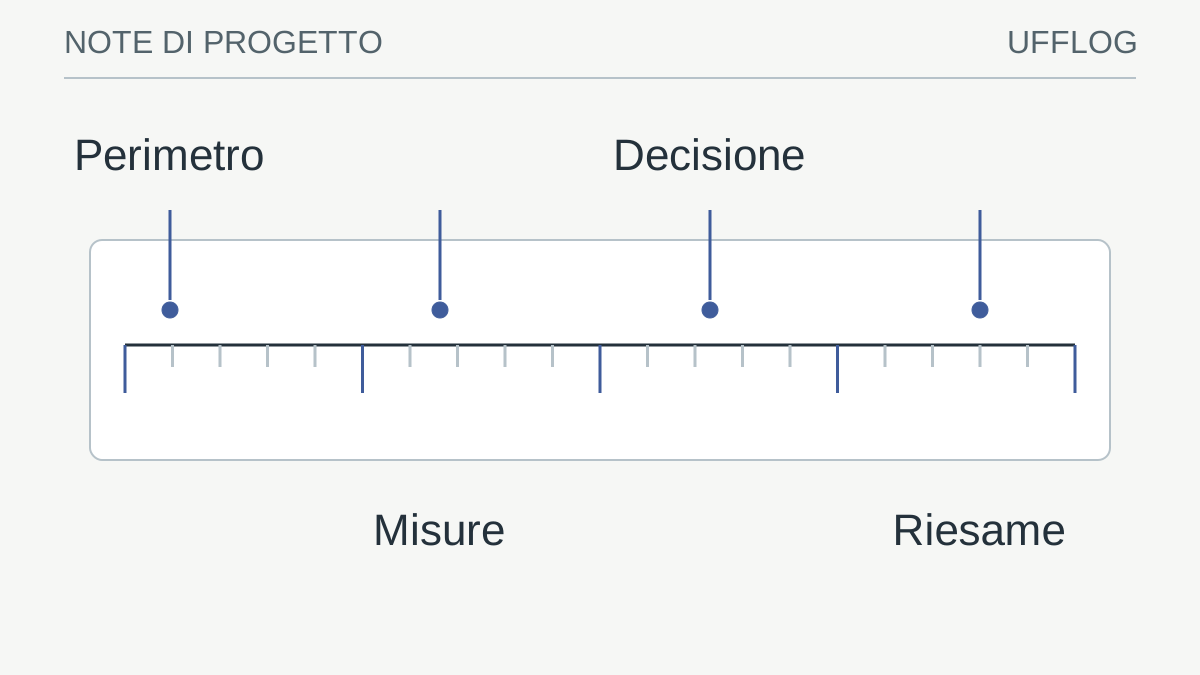
Le misure acquistano valore quando descrivono un perimetro e conducono a un'azione verificabile.
Leggi lo schema
- PerimetroSistemi attesi, osservati ed esclusi
- MisureDefinizioni, denominatori ed eccezioni
- DecisioneAzione, responsabile e criterio di riuscita
- RiesameEsito confrontato con l'obiettivo concordato
La verifica: Ogni problema rilevante conduce a un'azione o a un rinvio motivato?
Un grafico senza conseguenza operativa richiede un'interpretazione più precisa.
Interpretare patch e vulnerabilità nel contesto del servizio
Il conteggio delle patch installate non è da solo una misura della riduzione del rischio. Occorre sapere quali sistemi restano esposti, quali aggiornamenti sono applicabili e quali richiedono un collaudo o un riavvio. Un dispositivo che attende da settimane un’azione necessaria non dovrebbe apparire equivalente a uno che ha completato il percorso previsto.
Chiedi che le eccezioni abbiano motivazione, responsabile e condizione di riesame. Un software vincolato a una versione può richiedere una migrazione o controlli compensativi, non semplicemente un rinvio indefinito. Il rapporto deve distinguere l’aggiornamento non disponibile da quello disponibile ma non installato, e il dato sconosciuto da un esito verificato. Queste differenze determinano le azioni successive.
Evita confronti assoluti fra mesi se cambiano gli strumenti di rilevazione o il perimetro. Una nuova scansione può far emergere problemi preesistenti senza significare che l’ambiente sia peggiorato improvvisamente. Spiega la variazione metodologica e conserva una base comparabile. L’obiettivo è seguire il miglioramento reale: riduzione delle eccezioni, completamento dei riavvii autorizzati e verifica dei servizi dopo le modifiche, con priorità coerenti con l’impatto aziendale.
Trasformare un’anomalia ricorrente in un piano verificabile
Scegli le anomalie con impatto o ricorrenza maggiore e chiedi causa conosciuta, evidenze, azione proposta, responsabile e scadenza. Non trasformare una correlazione tra eventi in una causa certa. Per i servizi cloud gestiti, NSA e CISA richiamano la visibilità sulle attività del fornitore e la chiarezza delle responsabilità. [2] Il rapporto dovrebbe consentire di capire anche quali azioni amministrative significative sono state eseguite e quali richiedono una decisione del cliente, evitando dettagli sensibili non necessari ai lettori.
Una voce che ricompare ogni mese senza cambiamenti segnala un problema nella gestione delle decisioni. Può mancare un responsabile, un budget, una finestra o un’informazione tecnica. Il rapporto deve rendere esplicito questo blocco. «Da monitorare» non è un’azione sufficiente se non precisa quale segnale verrà osservato e quale condizione farà partire l’intervento.
Per una proposta utile descrivi situazione iniziale, modifica prevista e risultato atteso. Se un repository si riempie periodicamente, il piano potrebbe comprendere analisi della crescita, verifica della retention e valutazione della capacità. La conferma non sarà soltanto «spazio aumentato», ma un margine coerente con i cicli di lavoro e con i tempi necessari per reagire. Non attribuire automaticamente la causa alla prima correlazione visibile.
Assegna una data obiettivo interna e una condizione di chiusura. Nel rapporto successivo confronta l’esito con quella condizione, indicando eventuali effetti indesiderati. La guida agli alert utili aiuta a evitare che la soluzione consista soltanto nel silenziare la notifica. Una riduzione degli avvisi è positiva quando diminuisce il problema o migliora la rilevazione, non quando il controllo è stato rimosso senza una valutazione.
Verificare il mese successivo e conservare la continuità
Riprendi le decisioni del rapporto precedente e verifica chiusure, rinvii motivati ed effetti misurabili. Un rischio ripetuto senza proprietario non diventa meno importante perché compare ogni mese. Log Lens può aiutare a esaminare un estratto locale di eventi, ma non calcola da solo SLA o disponibilità end-to-end. Conserva rapporti e verbali nello spazio aziendale con accessi appropriati. Il risultato della lettura dovrebbe essere una breve lista di decisioni approvate e verifiche da ripetere; se il documento resta una raccolta di grafici senza conseguenze operative, va rivisto insieme al fornitore.
Rendere tracciabile il rapporto senza esporre informazioni superflue
Il documento deve permettere di risalire alle evidenze conservate nei sistemi autorizzati, ma non deve contenerle tutte. Può indicare riferimenti dei ticket, identificatori dei test e percorsi documentali accessibili ai lettori previsti. Password, token, configurazioni complete e dati personali non necessari non appartengono al riepilogo destinato alla direzione.
Prepara viste adatte ai destinatari. Il responsabile operativo può aver bisogno dei dettagli di una dipendenza; un amministratore aziendale può avere bisogno soprattutto della decisione economica e del rischio residuo. Le viste devono restare coerenti fra loro, usando gli stessi criteri e numeri. Non creare due narrazioni incompatibili soltanto per rendere il documento più rassicurante a un pubblico.
Se un assistente AI produce una sintesi, controlla che mantenga denominatori, esclusioni e incertezze. Una frase fluida può cancellare la differenza fra prova effettuata e proposta pianificata. Il referente che approva il rapporto deve poter verificare ogni conclusione sostanziale. Conserva anche le decisioni del confronto mensile: un breve verbale con azioni, proprietari e condizioni di verifica trasforma il documento in uno strumento di governo del servizio.
Anche il confronto economico richiede contesto. Un aumento dei ticket può riflettere un problema ricorrente, ma anche una migliore adozione del canale ufficiale dopo mesi di richieste informali. Prima di dedurre che il servizio sia peggiorato, confronta categorie, impatto e perimetro. Allo stesso modo, meno richieste non dimostrano automaticamente che gli utenti lavorino meglio: potrebbero aver smesso di segnalare un disagio noto.
Per collegare assistenza e prevenzione, scegli pochi casi rappresentativi e descrivi cosa è cambiato dopo l’intervento. Una procedura aggiornata, un componente sostituito o una dipendenza documentata possono ridurre interruzioni future, ma il risultato va osservato. Non attribuire un risparmio monetario a ogni ticket chiuso senza una base verificabile. Il rapporto può indicare ore di lavoro tecnico registrate, attività ripristinate e decisioni approvate, mantenendo distinti dati misurati e stime. Questa disciplina rende più credibile anche una proposta di investimento, perché mostra quale problema concreto si intende risolvere e quale evidenza permetterà di valutarlo.
Dalla guida a una verifica concreta.
Separa attività svolte, esiti verificati, eccezioni aperte e decisioni richieste. Collega ogni indicatore a un servizio e a un responsabile; un conteggio di ticket o patch non misura da solo la continuità del lavoro.
Risorse utili e progetti ufficiali
- Google SRE — Monitoring
Risorsa gratuita. Capitolo aperto per ragionare su segnali e impatto del servizio, senza copiare soglie universali.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Google SRE: monitorare sistemi distribuiti ↗sre.google
- NSA e CISA: rischi MSP negli ambienti cloud ↗media.defense.gov
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.