Una dimostrazione riuscita racconta un caso. Un set di valutazione mostra dove il sistema funziona, dove fallisce e quali cambiamenti peggiorano il risultato. Per un assistente aziendale il criterio non può essere soltanto “suona bene”: contano fonti, correttezza, permessi, tempi e capacità di fermarsi. Le valutazioni servono a rendere questi comportamenti confrontabili. [1]
Scrivi casi che rappresentino una decisione aziendale
Una domanda di prova deve avere un motivo per essere nel campione. “Quali servizi offrite?” verifica una capacità diversa da “Posso modificare questa configurazione senza approvazione?”. Collega ogni caso a un compito, a una conseguenza dell’errore e a un gruppo di utenti. Questo rende possibile scegliere le priorità senza inseguire un elenco generico di domande difficili.
Per un assistente su procedure interne puoi costruire quattro famiglie: trovare una procedura vigente, riconoscere una procedura sostituita, dichiarare l’assenza di una fonte e rifiutare una richiesta non autorizzata. Per un estrattore di documenti le famiglie potrebbero invece riguardare campi obbligatori, valori ambigui, tabelle spezzate e documenti fuori formato. Il campione deve rispecchiare il compito, non la modalità di presentazione che impressiona di più durante una demo.
Assegna un identificativo stabile a ogni caso e una breve spiegazione del criterio. Mantieni i dati sintetici quando bastano a riprodurre il comportamento; se servono esempi reali, autorizzali e minimizzali. Una procedura di prova ben descritta può essere ripetuta da una persona diversa dall’autore, senza dover interpretare intenzioni rimaste soltanto nella sua memoria.
Prepara una scheda di prova che un’altra persona possa ripetere
Una scheda minima contiene identificativo, compito, ruolo simulato, input, fonti disponibili, esito atteso e criterio di accettazione. Distingui ciò che il sistema deve comunicare da ciò che deve fare. In un esempio sintetico, una persona chiede lo stato della pratica DEMO-042: l’assistente deve leggere soltanto la pratica autorizzata e riportare lo stato restituito, senza inventare una data di consegna.
La stessa scheda può avere un secondo caso con un ruolo privo di accesso. L’esito atteso diventa un rifiuto circoscritto, senza rivelare se esistano pratiche di altri clienti. Il controllo non consiste soltanto nel leggere la risposta finale: occorre verificare anche quali dati sono stati recuperati e quali strumenti sono stati chiamati. Una risposta prudente non corregge un accesso indebito avvenuto prima.
Indica infine come ripristinare il laboratorio tra due esecuzioni. Se una prova precedente ha modificato lo stato di una pratica fittizia, quella successiva potrebbe partire da condizioni diverse. Preferisci dati sintetici e integrazioni di test senza effetti esterni. La ripetibilità dipende dal controllo di queste condizioni, oltre che dal modello. Microsoft distingue dataset, risposte e tracce operative: il livello scelto deve corrispondere alla proprietà che stai valutando. [2]
Separa dati di sviluppo, controllo e verifica finale
Durante lo sviluppo è normale osservare gli errori e correggere prompt, fonti o integrazioni. Se usi sempre gli stessi casi, però, il sistema può diventare molto bravo su quel piccolo insieme senza migliorare nel lavoro reale. Mantieni quindi un campione per gli aggiustamenti e uno distinto per il confronto finale, che non venga continuamente usato per orientare le modifiche.
Evita anche duplicati quasi identici tra i gruppi. Dieci riformulazioni dello stesso documento non sono dieci situazioni indipendenti. Quando più esempi derivano dalla stessa pratica, famiglia documentale o conversazione, considera di mantenerli nello stesso gruppo: altrimenti il risultato può beneficiare di informazioni già incontrate durante lo sviluppo.
Il campione finale non deve restare immutabile per sempre. Puoi aggiornarlo quando il servizio cambia, conservando però una parte stabile per rilevare regressioni e documentando la nuova composizione. La gestione delle versioni documentali per RAG aiuta a distinguere un errore del modello da un cambiamento delle fonti. Confrontare due versioni su materiali diversi senza annotarlo produce numeri apparentemente precisi ma difficili da interpretare.
Combina controlli deterministici e giudizio competente
Alcune proprietà si verificano direttamente: presenza dei campi richiesti, validità di un formato, identificativo di una fonte, destinatario di un’azione, assenza di una chiamata vietata. Usa controlli deterministici per queste condizioni. Non chiedere a un modello di assegnare un voto a un numero di pratica quando puoi confrontarlo con il valore atteso.
Altre proprietà richiedono giudizio: una spiegazione è comprensibile? La risposta contiene un’omissione che cambia la decisione? La fonte supporta davvero la conclusione? Prepara una rubrica con esempi di esito accettabile, parziale e non accettabile. Fai valutare un sottoinsieme a più persone competenti e discuti i disaccordi: spesso rivelano un requisito poco chiaro, non soltanto un valutatore distratto.
Un secondo modello può aiutare a classificare molti risultati, ma non costituisce automaticamente una misura indipendente e corretta. Confrontalo con giudizi umani, controlla la sensibilità all’ordine delle risposte e verifica che non premi soltanto lunghezza o tono sicuro. Anthropic descrive la necessità di valutare sia le tracce sia gli esiti degli agenti; una formulazione elegante può convivere con un’operazione sbagliata. [1]
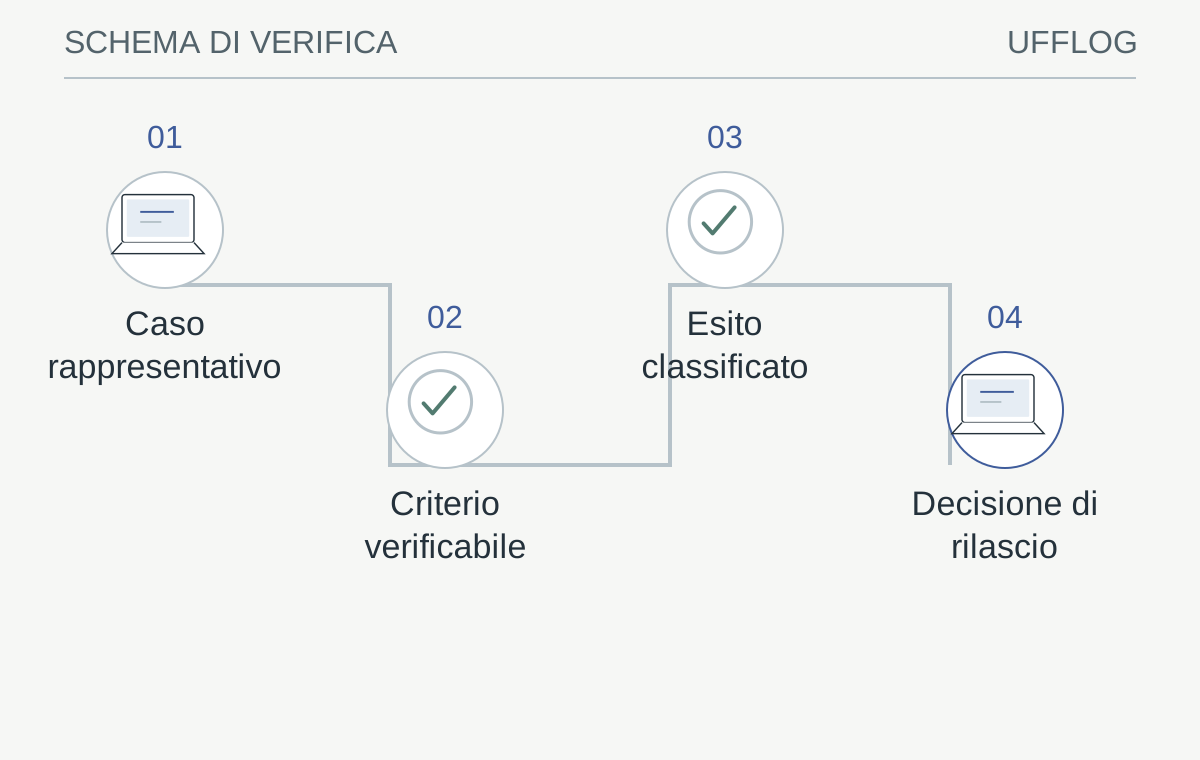
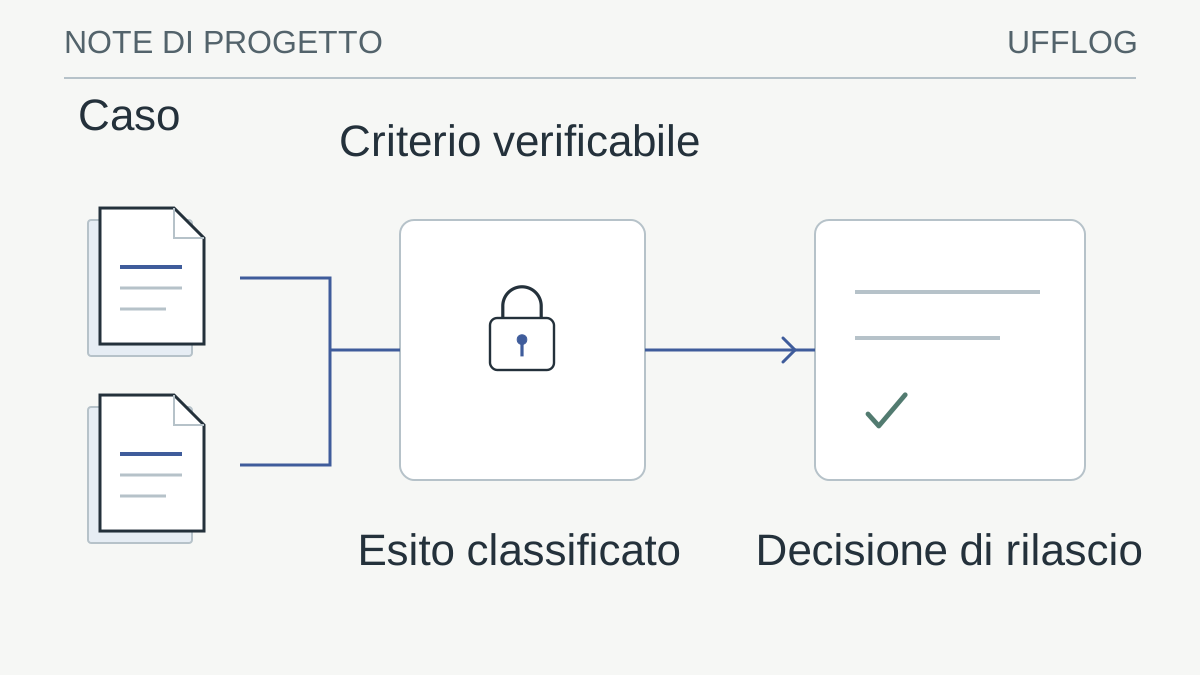
Il rilascio deriva da casi rappresentativi e criteri espliciti, non dal tono convincente della risposta.
Leggi lo schema
- Caso rappresentativoCompito, contesto e conseguenza dell’errore
- Criterio verificabileFatti richiesti, divieti e risultato operativo
- Esito classificatoQualità, permessi, tempi e costo separati
- Decisione di rilascioRegressioni e limiti valutati dal responsabile
La verifica: Un errore critico resta visibile anche quando la media migliora?
Ottimizzare sempre sugli stessi esempi può migliorare il test senza migliorare il servizio.
Calibra la valutazione prima di produrre il punteggio finale
Fai leggere a due revisori un piccolo gruppo di risposte senza mostrare il nome del modello. Se attribuiscono esiti diversi, confronta le motivazioni e chiarisci la rubrica. Il problema può essere una fonte ambigua o una regola aziendale mai formalizzata. Non risolvere il disaccordo semplicemente facendo la media di due voti incompatibili.
Usa esempi che separino forma e contenuto: una risposta breve ma completa, una risposta elegante con una condizione inventata, un rifiuto corretto e uno eccessivo. Per ciascuno spiega quale requisito decide l’esito. Evita criteri vaghi come “sembra professionale” se la conseguenza importante è l’invio al destinatario corretto. Il tono può avere una valutazione separata, subordinata alla correttezza delle informazioni e delle azioni.
Quando impieghi un valutatore automatico, controlla un campione dei suoi giudizi e registra i casi di disaccordo con le persone. Il valutatore è una componente del sistema di misura, non l’autorità finale sulla qualità. Ricalibralo quando cambia il tipo di documento, il pubblico o il compito: una rubrica valida per risposte informative potrebbe non essere sufficiente per azioni che generano ordini o modificano dati.
Guarda la distribuzione degli errori, non un voto unico
Un tasso complessivo del novantacinque per cento non dice quali siano i cinque casi falliti su cento. Potrebbero essere domande marginali oppure gli unici casi che riguardano autorizzazioni e dati riservati. Organizza gli esiti per categoria, gravità e gruppo di utenti, mantenendo visibili i numeri assoluti. Una percentuale su due esempi ha un significato diverso dalla stessa percentuale su duecento.
Distingui almeno risposta corretta, risposta incompleta, risposta non supportata, rifiuto corretto, rifiuto improprio e azione errata. Per un sistema che usa strumenti aggiungi se il risultato dichiarato corrisponde allo stato effettivo del servizio destinatario. Per un RAG separa recupero della fonte e interpretazione: non trovare il documento corretto richiede un intervento diverso da leggerlo e trarne una conclusione infondata.
Quando il comportamento varia tra esecuzioni, ripeti i casi importanti e registra la variabilità. Non scegliere soltanto il tentativo migliore da mostrare. Definisci in anticipo condizioni che bloccano il rilascio, come un accesso oltre il perimetro autorizzato, indipendentemente dalla media. Le metriche devono rendere più facile una decisione responsabile, non fornire un numero favorevole a qualunque costo.
Valuta anche tempi, costi e comportamento in difficoltà
La correttezza non basta se il servizio impiega un tempo incompatibile con il compito o consuma il budget con pochi casi. Misura latenza, numero di passaggi e consumo sullo stesso campione usato per la qualità. Osserva le richieste più lente e costose, non soltanto la media, e verifica se corrispondono a lavoro realmente più complesso oppure a cicli inutili.
Aggiungi prove con fonte temporaneamente non disponibile, risposta di uno strumento incompleta e limite di consumo raggiunto. Il comportamento atteso può essere una spiegazione chiara e un percorso alternativo, non necessariamente una risposta completa. La guida al passaggio a una persona mostra come distinguere un’escalation dichiarata da una richiesta realmente ricevuta dal servizio umano.
Queste prove devono usare ambienti e dati controllati. Non interrompere servizi produttivi per vedere come reagisce il bot. Simula l’esito dell’integrazione nel laboratorio o usa una configurazione di test prevista dal fornitore. Una valutazione seria documenta anche i limiti della simulazione: il risultato di un servizio fittizio non dimostra automaticamente che il sistema reale manterrà gli stessi tempi o stati durante un incidente.
Conserva evidenze utili al rilascio e alla manutenzione
Il rapporto finale dovrebbe consentire di ricostruire quali versioni sono state confrontate: modello, prompt, regole, strumenti, indice e fonti. Conserva input di prova autorizzati, risultati, valutazioni e motivazioni dei casi critici. Per le tracce operative minimizza i contenuti sensibili; spesso identificativi, esiti e riferimenti al campione controllato bastano a riprodurre il difetto senza duplicare documenti aziendali.
Associa ogni difetto rilevante a una decisione: correggere, restringere il perimetro, introdurre revisione umana oppure accettare esplicitamente il limite. La guida al cambio di modello usa questo stesso principio per impedire che un miglioramento medio nasconda una regressione operativa. L’approvazione deve riguardare la configurazione collaudata, non il nome commerciale di un prodotto.
Dopo l’avvio raccogli nuovi casi dai problemi osservati, trasformandoli in esempi minimizzati e ripetibili. Non serve archiviare ogni conversazione per sempre. Il valutatore di progetto AI aiuta a discutere sostenibilità e revisione; il set di prove rende poi verificabile quella discussione. Il risultato migliore è un processo che sa riconoscere quando una modifica migliora il servizio e quando è più prudente non pubblicarla.
Prima di approvare un aggiornamento, chiedi infine a chi conosce il processo di leggere alcuni errori concreti. Un elenco di percentuali non sostituisce la comprensione delle conseguenze. Se un errore viene giudicato innocuo soltanto perché il caso è sintetico, traduci il suo effetto nel lavoro reale: un destinatario sbagliato, una condizione commerciale inventata o un permesso ignorato restano categorie operative, non difetti puramente linguistici.
Dalla guida a una verifica concreta.
Separa esempi facili, casi limite e richieste da rifiutare. Conserva risposte attese e criteri di giudizio prima del test; aggiungere soltanto i casi riusciti renderebbe il confronto poco utile.
Risorse utili e progetti ufficiali
- Promptfoo
Progetto open source. Framework per valutazioni ripetibili. Le chiamate a modelli esterni possono avere costi e trasferire dati.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Anthropic — Valutazioni degli agenti AI ↗anthropic.com
- Microsoft — Valutazione di modelli e applicazioni generative ↗learn.microsoft.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.