Un cluster con tutte le VM accese non dimostra di avere capacità sufficiente dopo la perdita di un nodo. Per valutare l’alta disponibilità bisogna distinguere quorum, accesso ai dati e risorse rimaste. La documentazione Proxmox tratta questi requisiti e il ruolo della comunicazione di cluster. [1] [2] Questa guida prepara il dimensionamento; non propone di staccare un nodo produttivo per vedere cosa succede.
Definisci il guasto che vuoi tollerare
Scegli lo scenario: manutenzione di un host, perdita di un nodo o indisponibilità di un componente di storage. Elenca servizi prioritari e risorse che devono rimanere operative. Verifica versione, modello di storage, reti e policy HA effettive. Non sommare semplicemente la RAM di tutti i nodi: alcune risorse possono non essere disponibili alla macchina che dovrebbe ospitare il servizio.
Concorda prestazioni minime accettabili e quali carichi possono restare sospesi durante l’emergenza.
Descrivi l’effetto atteso del guasto sul lavoro. Alcuni servizi possono tollerare un riavvio, altri richiedono una continuità applicativa più stretta. L’HA della piattaforma non equivale automaticamente a interruzione nulla: il rilevamento e il recupero richiedono tempo e l’applicazione deve tornare pronta. Il progetto deve distinguere disponibilità dell’infrastruttura e disponibilità del processo.
Scegli un solo scenario iniziale e documenta ciò che resta escluso. La perdita di un nodo è diversa dalla perdita di uno switch, dello storage condiviso o dell’intera sede. Un progetto che copre il primo non può essere presentato come soluzione universale agli altri. Le priorità aiutano a investire dove il fermo produce l’effetto maggiore.
Coinvolgi il referente applicativo per definire la prestazione minima dopo il recupero. Un servizio che riparte ma non sostiene il numero di utenti previsto può essere tecnicamente disponibile e operativamente insufficiente. La prova deve quindi includere un carico e una funzione rappresentativi, entro i limiti concordati.
Separare manutenzione pianificata e guasto improvviso
Una migrazione pianificata può spostare un carico mentre il nodo sorgente è ancora disponibile, secondo funzionalità e requisiti della piattaforma. Un guasto improvviso può richiedere il riavvio altrove dopo rilevamento e condizioni di sicurezza. Le due prove non sono equivalenti e non devono produrre la stessa promessa di continuità.
Per la manutenzione prepara la capacità del nodo destinatario e verifica il percorso di spostamento. Per il guasto considera anche lo stato applicativo, l’accesso ai dati e il tempo di ripartenza. Una procedura che funziona quando tutti i componenti collaborano può non rappresentare ciò che accade quando una dipendenza manca.
Definisci quindi criteri diversi nel collaudo: operazioni mantenute durante la manutenzione e operazioni recuperate dopo un’interruzione. Questa distinzione aiuta la direzione a comprendere il valore dell’HA senza trasformarla in una garanzia di servizio continuo per qualsiasi evento.
Calcola il carico sui nodi residui
Raccogli utilizzo rappresentativo di CPU, memoria, storage e rete, includendo i picchi. Simula sulla carta la distribuzione dei servizi dopo il guasto scelto e considera vincoli di affinità, dispositivi locali e accesso ai dischi. Una VM con risorse particolari potrebbe non poter partire su qualsiasi nodo.
Mantieni un margine esplicito per sistema, crescita e operazioni di recupero. Il calcolatore RAID può confrontare capacità dello storage, ma non misura la capacità HA del cluster né le prestazioni durante una ricostruzione.
In un esempio ipotetico, tre nodi offrono ciascuno 110 GiB effettivamente disponibili per i carichi dopo le riserve di sistema. Il totale ordinario è 330 GiB; perdendo un nodo restano 220 GiB. Se i carichi necessari richiedono 240 GiB, la somma iniziale nasconde un deficit nello scenario di guasto. Occorre aumentare capacità, ridurre i carichi prioritari o concordare una modalità degradata.
La memoria è soltanto una dimensione. Verifica CPU, prestazioni dello storage, rete e vincoli di collocazione. Una VM con dispositivo locale o risorsa particolare potrebbe avere un solo nodo eleggibile. La documentazione Proxmox lega l’esecuzione HA alla disponibilità delle dipendenze sui nodi consentiti. [2] Il calcolo deve usare quella disponibilità reale, non ogni nodo indistintamente.
Ripeti il ragionamento per il nodo la cui perdita produce la condizione peggiore. In un cluster eterogeneo i nodi non offrono la stessa capacità. Un calcolo fatto sul componente più piccolo può risultare rassicurante ma non rappresentare il guasto più impegnativo per l’ambiente.
Verificare il dato, non soltanto il nodo di calcolo
La VM può ripartire soltanto se i suoi dati sono disponibili nel modo richiesto dall’architettura. Storage condiviso, distribuito o replicato presentano dipendenze differenti. Il progetto deve identificare quali guasti sono coperti, quali percorsi restano e quali condizioni possono introdurre perdita di aggiornamenti o indisponibilità. Non usare la parola replica come sinonimo universale di dato sempre identico.
Se uno storage condiviso dipende da un unico componente senza alternativa prevista, più nodi di calcolo non eliminano quel punto di fermo. Anche rete e alimentazione possono condividere risorse. Disegna i domini di guasto, indicando quali elementi cadono insieme nello scenario scelto.
La guida al backup ibrido tratta una protezione complementare. L’HA tende a mantenere o recuperare l’esecuzione; il backup offre punti di recupero per scenari diversi. Un errore o una compromissione può interessare anche dati replicati, quindi i due percorsi devono essere progettati insieme.
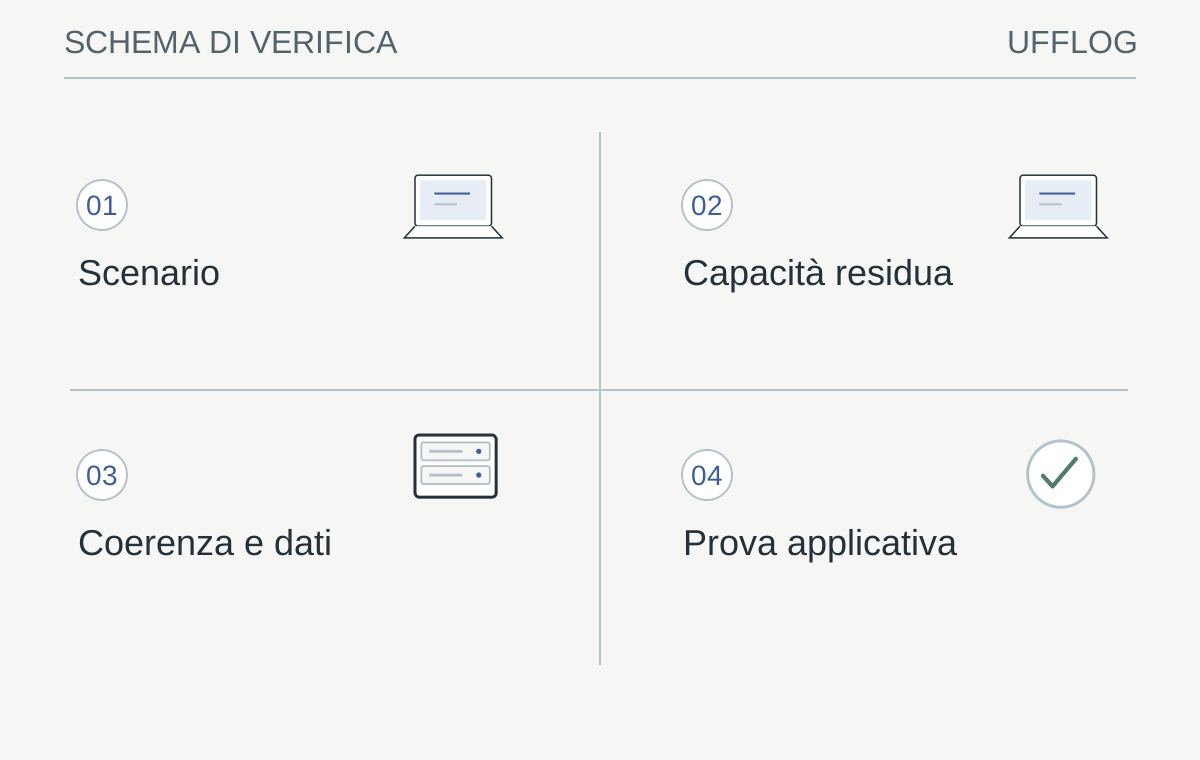
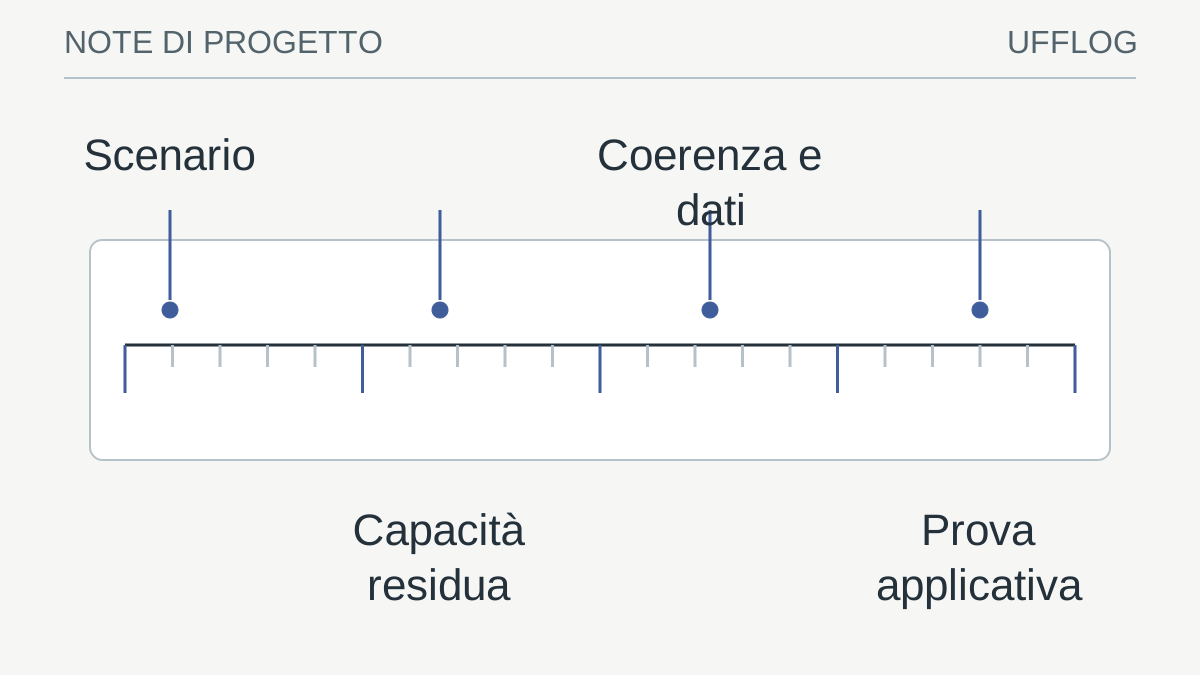
Schema di verifica illustrativo: risorse e dipendenze sono valutate prima della prova operativa.
Leggi lo schema
- ScenarioGuasto e carichi prioritari
- Capacità residuaRisorse sui nodi eleggibili
- Coerenza e datiQuorum, fencing e storage disponibili
- Prova applicativaTempo e funzione dopo il recupero
La verifica: Quorum, dati e risorse sono disponibili contemporaneamente?
Se manca una condizione, il cluster non copre lo scenario dichiarato.
Verifica quorum e percorsi di gestione
Controlla che il progetto di quorum sia coerente con la topologia e che la comunicazione fra nodi abbia i requisiti previsti. Per configurazioni particolari, come cluster piccoli con voto esterno, segui la documentazione applicabile e verifica le dipendenze del dispositivo aggiuntivo. Non modificare voti o soglie per forzare un cluster degradato durante una prova improvvisata.
Considera separatamente il percorso di amministrazione: chi interviene deve poter osservare lo stato senza dipendere soltanto dal servizio che è diventato indisponibile.
Il quorum riguarda la possibilità di prendere decisioni coerenti nel cluster; non fornisce RAM, spazio o accesso ai dischi. Un ambiente può mantenere quorum e non avere risorse sufficienti per i carichi previsti. Viceversa, risorse fisiche disponibili non autorizzano a ignorare una condizione di cluster non sicura. Questi controlli devono essere separati nel progetto e nel verbale.
La comunicazione fra nodi e i meccanismi di fencing proteggono la coerenza in condizioni di guasto o separazione. Verifica requisiti e comportamento nella documentazione della versione. Non modificare voti, timeout o controlli per ottenere una dimostrazione apparentemente riuscita. Una prova che aggira il meccanismo da verificare non misura l’affidabilità del progetto.
Il percorso di gestione deve restare raggiungibile alle persone autorizzate. Considera identità, rete e strumenti necessari per osservare lo stato anche quando una VM di servizio è ferma. La mappa delle dipendenze amministrative evita che il team disponga di capacità residua ma non riesca a usarla o a capire perché il recupero si è arrestato.
Osservare lo stato HA senza modificarlo
Su un nodo Proxmox autorizzato, il comando seguente mostra lo stato del gestore HA. È una lettura: non aggiunge risorse, non cambia quorum e non avvia migrazioni. Richiede un accesso amministrativo appropriato e il risultato va conservato nel perimetro aziendale, perché può contenere nomi interni. [2]
ha-manager statusL’output può aiutare a identificare stato e collocazione delle risorse gestite. Non misura da solo la capacità residua, le prestazioni applicative o la raggiungibilità di tutte le dipendenze. Una riga favorevole sul quorum non certifica l’intero progetto HA.
Confronta lo stato con la configurazione prevista e con le metriche dei nodi. Se emergono risorse inattese o errori, raccogli l’evidenza e segui il percorso di assistenza del prodotto. Non usare comandi trovati online per forzare la condizione finché non sia stata compresa la causa.
Collauda con una procedura autorizzata
Prepara un laboratorio o una finestra di manutenzione con backup, criteri di arresto e piano di ritorno. Verifica migrazione o riavvio dei carichi previsti e fai validare il servizio dall’utente, registrando tempi e prestazioni. Non confondere HA con protezione da cancellazioni o compromissioni: anche il cluster necessita di backup indipendenti. Aggiorna il calcolo dopo nuove VM o crescita dei carichi, così la capacità residua rimane una misura del progetto e non un’ipotesi storica.
Il piano di collaudo specifica stato iniziale, scenario, operatori, evidenze e criterio di arresto. Non occorre iniziare con il guasto più invasivo: una verifica di manutenzione pianificata può confermare alcuni percorsi, mentre altri richiedono un laboratorio o una prova dedicata. Dichiara ciò che ogni esercizio dimostra e ciò che non simula.
Misura separatamente il tempo della piattaforma e quello dell’applicazione. Il servizio può risultare avviato nella console prima che l’utente completi l’operazione prevista. Registra anche carico sui nodi residui e anomalie, perché un rientro rapido seguito da saturazione non soddisfa necessariamente il requisito. Il referente del processo deve confermare il risultato operativo.
Dopo la prova verifica che cluster, backup e monitoraggio siano tornati nella condizione concordata. Le modifiche temporanee e le eccezioni devono essere chiuse. La guida al test di failover aiuta a documentare anche il ritorno, evitando che una prova riuscita lasci una distribuzione o una protezione diversa da quella prevista.
Mantenere valido il calcolo quando il cluster cresce
Ogni nuova VM o modifica di risorse può consumare il margine che sosteneva lo scenario di guasto. Inserisci la verifica della capacità residua nel processo di approvazione dei carichi. Il fatto che una macchina si avvii in condizioni ordinarie non dimostra che il cluster possa sostenerla dopo la perdita di un nodo.
Rivedi anche vincoli di collocazione e dipendenze locali. Un nuovo dispositivo o una modifica di rete può ridurre i nodi su cui una risorsa può essere eseguita. La documentazione deve restare allineata alla configurazione effettiva, senza affidarsi a un diagramma preparato durante l’installazione iniziale.
La guida alla capacità infrastrutturale collega misure e crescita. Conserva una scheda dello scenario con risorse disponibili, carichi prioritari e limiti. Il valore dell’HA viene mantenuto attraverso queste revisioni e prove, non soltanto acquistato con un nodo aggiuntivo o attivato da una casella nella console.
Dalla guida a una verifica concreta.
Ricalcola la capacità escludendo il nodo più impegnato e considera anche storage e rete. Annota separatamente quorum e risorse disponibili: poter decidere un riavvio non significa avere memoria e capacità sufficienti per eseguirlo.
Risorse utili e progetti ufficiali
- Proxmox VE — Architecture and features
Documentazione pubblica. Riferimento del progetto per virtualizzazione, storage e alta disponibilità, con accesso al codice ufficiale.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Proxmox — Guida amministrativa corrente ↗pve.proxmox.com
- Proxmox: documentazione ufficiale High Availability ↗github.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.