Un processo di backup terminato correttamente è un’informazione importante: indica che una determinata operazione ha rispettato i controlli previsti dal sistema. Non risponde, da solo, a una domanda diversa: le persone riuscirebbero a usare il servizio recuperato? Fra copia e lavoro esistono applicazioni, identità, reti e sequenze di avvio. Un test di ripristino serve a rendere osservabile questo percorso.
La prova comincia da una domanda precisa
“Verificare i backup” è un obiettivo troppo ampio per essere misurato. Meglio formulare uno scenario: recuperare il gestionale da un punto di ripristino scelto, in una rete isolata, e completare una specifica operazione di consultazione. Oppure restituire a un utente una cartella con i relativi permessi. Scenari differenti richiedono preparazione, evidenze e criteri di successo differenti.
Il perimetro deve indicare anche ciò che non viene verificato. Avviare una macchina virtuale non prova automaticamente l’intero processo di fatturazione. Recuperare un database non dimostra che una sede remota possa raggiungerlo. Dichiarare i limiti della prova aumenta l’utilità del risultato, perché evita che una verifica circoscritta diventi una rassicurazione generale non sostenuta dai fatti.
Costruisci una scala delle evidenze
Per interpretare il risultato di un backup conviene distinguere almeno quattro livelli. Il primo è l’esecuzione del job: il motore dichiara di aver concluso le attività previste. Il secondo è la disponibilità della copia: catalogo, supporto e chiavi permettono di raggiungere il contenuto. Il terzo è il recupero tecnico di un oggetto, come un file o una macchina. Il quarto è la ripresa di una funzione di lavoro con dati coerenti e accessi appropriati.
Questi livelli non sono intercambiabili. Un file può essere copiato senza errori, ma non appartenere all’insieme di dati necessario al servizio. Una macchina può avviarsi e non riuscire a contattare il database. Un’applicazione può aprirsi con l’account amministrativo e risultare inutilizzabile per gli operatori. Ogni osservazione risponde a una domanda diversa: la relazione dovrebbe rendere immediatamente visibile quale domanda sia stata effettivamente affrontata.
Una scala delle evidenze aiuta anche a evitare due estremi. Non è corretto considerare inutile un job riuscito: è un segnale necessario per la gestione ordinaria. Non è corretto farne una dimostrazione completa della continuità. La decisione nasce dall’insieme di segnali, copertura e prove. Quando manca un livello, scrivi «non verificato» invece di convertirlo arbitrariamente in un esito positivo o negativo.
Individua il falso senso di copertura
Immagina un’azienda che vede ogni notte un job verde relativo alla macchina del gestionale. Il database effettivo potrebbe però trovarsi su un altro server, un allegato su una condivisione e una funzione di firma su un servizio esterno. Il job può essere tecnicamente corretto e coprire solo una parte del servizio. Il primo controllo riguarda quindi la mappa dei dati e delle dipendenze, non la percentuale di successo della console.
Raccogli cosa viene incluso, escluso e scoperto automaticamente. Verifica come si rilevano nuove macchine, nuovi volumi, cartelle spostate e account cloud appena creati. Le esclusioni non sono sempre un errore: possono essere deliberate per evitare file temporanei o contenuti ricostruibili. Diventano un problema quando nessuno conosce la motivazione o quando la classificazione cambia senza una revisione del piano.
Valuta anche il significato dell’avviso. Alcuni riepiloghi distinguono successo, warning e fallimento; una dashboard aggregata potrebbe mostrare solo lo stato prevalente. Non ricostruire la copertura da un unico colore. Cerca il dettaglio degli oggetti e delle eccezioni, poi collegalo a un responsabile del servizio. La mappa dell’infrastruttura serve proprio a collegare i sistemi al lavoro, evitando che un server non inventariato diventi invisibile anche al backup.
Le dipendenze che allungano il recupero
Una macchina può dipendere da DNS, autenticazione, certificati, licenze o condivisioni esterne. Prima del test queste relazioni vanno identificate almeno per il servizio scelto. Altrimenti una difficoltà di accesso verrà attribuita al backup, quando il problema è una dipendenza assente nell’ambiente di prova. Anche questo è un risultato utile, purché venga interpretato correttamente.
Le credenziali di emergenza devono essere disponibili alle persone autorizzate senza dipendere esclusivamente dal sistema che si sta ripristinando. Lo stesso vale per istruzioni e configurazioni. Un documento di recupero conservato soltanto sul server indisponibile è formalmente presente ma operativamente difficile da usare. La preparazione comprende quindi accessi, strumenti e responsabilità.
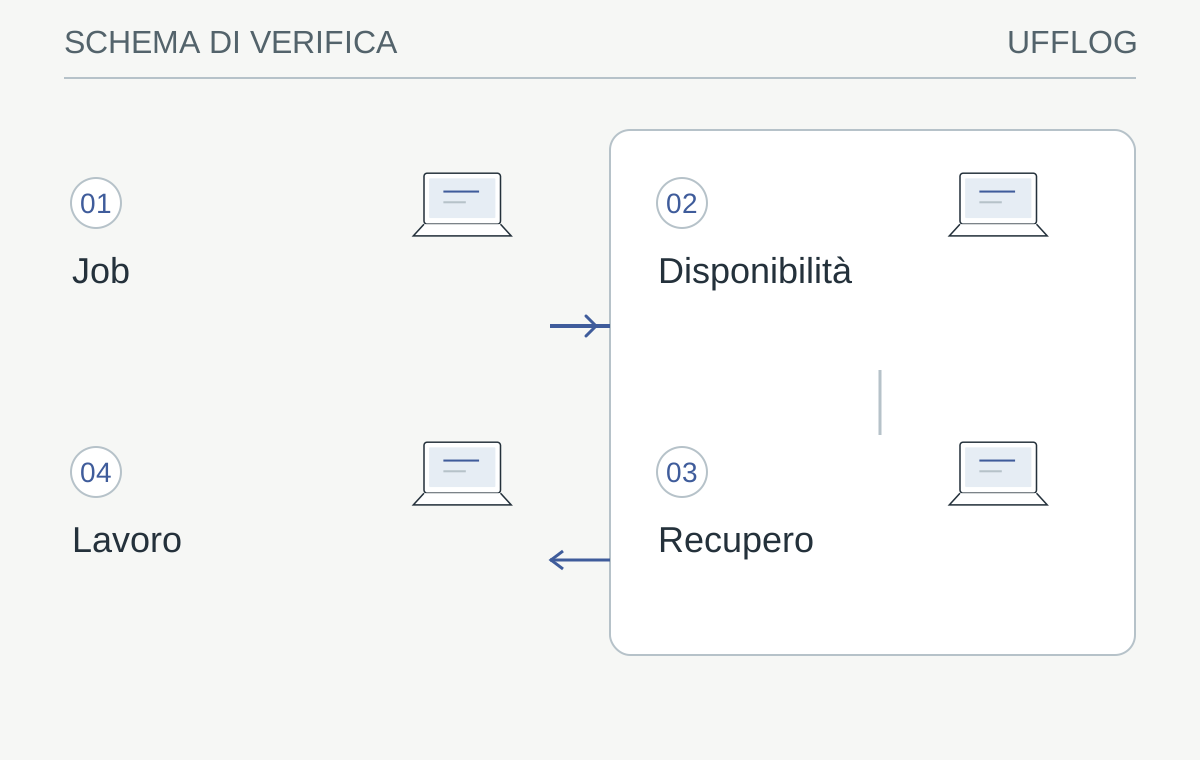
Schema concettuale del percorso di verifica; non rappresenta una prova già eseguita.
Leggi lo schema
- JobEsito della copia configurata
- DisponibilitàCatalogo, supporto e chiavi accessibili
- RecuperoOggetto ripristinato in isolamento
- LavoroFunzione validata dall’utilizzatore
La verifica: Quale livello è stato realmente dimostrato?
Se manca un livello, indica non verificato e prepara la prova specifica.
Confronta verifica automatica e prova dell’utilizzatore
Le verifiche automatizzate possono controllare aspetti ripetibili e ampliare la frequenza delle osservazioni. Il loro valore dipende dal test configurato: avvio, risposta di un servizio o uno script applicativo non sono la stessa cosa. Prima di interpretare un report, leggi esattamente quali controlli sono previsti, quali dipendenze vengono avviate e cosa costituisce un errore. Le funzioni disponibili dipendono da prodotto, piattaforma e configurazione. [1]
Il test dell’utilizzatore aggiunge un punto di vista diverso: l’attività richiesta riesce nel modo necessario al lavoro? Non deve essere una visita informale alla schermata iniziale. Prepara operazioni campione, risultato atteso e criteri di accettazione. Se il ruolo operativo non ha i permessi corretti, un amministratore che riesce a vedere tutto non risolve la domanda. Documenta la differenza e correggi il percorso verificando anche i privilegi.
Automazione e verifica umana possono essere combinate. Un controllo periodico rileva anomalie tecniche, mentre una sessione applicativa viene ripetuta dopo cambiamenti significativi o secondo un piano concordato. Non promettere che l’automazione elimini la necessità di decidere cosa provare. Il lavoro di progettazione resta nel collegamento fra controlli, rischio e servizio. Una prova documentata rende questa combinazione ripetibile.
Misurare tutto il percorso
Un esempio ipotetico: trasferire i dati richiede cinquanta minuti, avviare i servizi venti e correggere una dipendenza quaranta. Dichiarare un recupero di cinquanta minuti nasconderebbe la parte più utile della prova. Occorre distinguere tempi tecnici, attese e attività manuali, registrando inizio e fine delle fasi realmente rilevanti per l’azienda.
Il cronometro non deve servire a produrre il numero più basso. Deve individuare dove intervenire. Una procedura più chiara può ridurre un’attesa; un accesso mancante richiede una correzione organizzativa; un trasferimento troppo lento può richiedere un diverso progetto di storage o connettività. La relazione dovrebbe collegare ogni priorità all’evidenza che l’ha generata.
Un tempo di recupero osservato ha senso solo insieme alle condizioni. Riportare «quaranta minuti» senza quantità, sorgente, destinazione e verifica applicativa non consente un confronto. La stessa copia può essere letta da un repository locale, scaricata da un servizio remoto o ricostruita dopo la perdita della console. In ciascuno scenario cambiano preparazione, dipendenze e disponibilità delle persone.
Se una prova recupera duecento gigabyte, non moltiplicare automaticamente il tempo per prevedere il recupero di due terabyte. Il percorso potrebbe includere costi fissi, operazioni non lineari, limiti di concorrenza o colli di bottiglia differenti. Usa una stima per preparare il piano, poi esplicita il margine di incertezza. Una misura puntuale è un’evidenza più forte per il caso provato, ma non è un modello completo di tutti gli scenari.
Anche la data della copia va interpretata. Il punto selezionato può essere recente e non coerente con l’ultima operazione aziendale. Per l’RPO interessa il punto recuperabile che consente una ricostruzione accettabile, non soltanto l’orario scritto accanto al job. La distinzione fra RTO e RPO permette di evitare che velocità di recupero e quantità di aggiornamenti perduti vengano mescolate nello stesso indicatore.
Mantieni le evidenze confrontabili dopo un cambiamento
Un verbale è riutilizzabile quando permette di distinguere un cambiamento del sistema da un cambiamento della prova. Registra software e versione, oggetto recuperato, punto della copia, destinazione e criteri applicativi. Se due sessioni usano campioni diversi, non descrivere la differenza di tempo come un miglioramento automatico. Potrebbero essere cambiate quantità, dipendenze o condizioni di carico.
Scegli un piccolo nucleo di controlli stabile e affiancagli casi che cambiano secondo il rischio. Il nucleo può riguardare accesso, contenuto campione e funzione principale; i casi aggiuntivi possono coprire un archivio storico, un nuovo ruolo o una dipendenza appena introdotta. Questa distinzione consente sia un confronto nel tempo sia un ampliamento della copertura, senza pretendere che una sola prova rappresenti tutta l’azienda.
Conserva il collegamento tra anomalia, intervento e nuova verifica. Se mancava una chiave, il nuovo esito deve dimostrare il recupero da parte del referente autorizzato nelle condizioni previste. Un ticket chiuso non è di per sé la prova che il ripristino ora riesca. Quando l’intervento cambia altri componenti, valuta anche i controlli che potrebbero essere influenzati.
Prepara una versione del rapporto adatta al destinatario. La direzione ha bisogno di funzione recuperata, limiti e decisioni; il tecnico deve poter ricostruire la sequenza. I riferimenti alle evidenze possono essere condivisi senza distribuire copie indiscriminate dei dati. La verifica di recupero non richiede che informazioni riservate compaiano in ogni schermata o in ogni allegato del rapporto.
Porta alla direzione una decisione circoscritta
La conclusione dovrebbe rispondere a una domanda operativa. «La copia esiste» è utile per il tecnico; «la consultazione degli ordini è stata ripristinata nella sandbox, mentre l’invio documenti non è stato incluso» consente alla direzione di capire la copertura. Il linguaggio deve mantenere la stessa precisione quando la prova fallisce: indica che cosa non è riuscito, senza attribuire automaticamente il problema all’intera strategia di backup.
Collega ogni lacuna a una scelta: ampliare l’inclusione dei dati, separare una dipendenza, rendere recuperabile una chiave, aumentare capacità oppure rivedere un obiettivo non sostenibile. La scelta può comportare un investimento, ma prima deve essere chiaro quale evidenza la giustifichi. Non tutte le anomalie richiedono nuovi prodotti; una responsabilità non assegnata o una procedura non aggiornata può bloccare anche un’infrastruttura costosa.
La revisione successiva verifica se l’intervento ha ridotto l’incertezza. Conserva quindi perimetro, condizioni e criteri della prova precedente. Senza questi riferimenti, due report positivi non dimostrano un miglioramento. L’obiettivo non è accumulare documenti o percentuali rassicuranti, ma trasformare una conclusione in un percorso verificabile che permetta di intervenire prima che il recupero diventi urgente.
NOTE DI LABORATORIO / DA ADATTARE
Una prova che produce evidenze.
Il risultato utile è un servizio verificato, con tempi e limiti leggibili. Qui trovi un esempio di misura e una scheda da adattare al tuo software di backup.
01 · Scrivi prima il criterio di successo
Scegli un servizio circoscritto, un responsabile e una copia autorizzata. Registra software e versione del backup, punto di recupero e dipendenze: identità, DNS, rete, applicazione e chiavi custodite con le procedure aziendali. La scheda contiene riferimenti alle evidenze, mai password o chiavi.
- Concorda un ambiente isolato senza conflitti con produzione e integrazioni esterne.
- Definisci almeno un accesso autorizzato e un’operazione su dati sintetici da verificare.
- Assegna chi conferma il risultato e come si interrompe la prova se il perimetro cambia.
Una prova con perimetro, criteri di accettazione e condizioni di arresto esplicite.
Nessun restore viene avviato dal sito o dal modello scaricato. L’esecuzione richiede un piano specifico dell’ambiente.
02 · Misura fino al lavoro accettato
Scenario interamente sintetico: interruzione alle 09:00 UTC, punto recuperabile delle 08:45, operatività accettata alle 10:10. L’intervallo osservato è 70 minuti; l’età del punto al momento dell’interruzione è 15 minuti. Se l’RTO concordato è 60 minuti, il tempo lo supera. Un MTPD di 120 minuti non trasforma questo esito in un RTO rispettato.
- Usa istanti con fuso e la stessa origine temporale per tutti i partecipanti.
- Separa rilevazione, decisione, trasferimento, avvio e validazione applicativa.
- Confronta separatamente obiettivo di tempo e perdita dati effettivamente verificata.
{
  "mode": "synthetic-example",
  "rtoTargetMinutes": 60,
  "elapsedMinutes": 70,
  "restorePointAgeAtIncidentMinutes": 15,
  "applicationAcceptance": "not-performed"
}
Dati dimostrativi. Nessuna prova è stata eseguita.
Nel JSON dimostrativo i cinque intervalli sommano 70. Il modello vuoto mantiene i valori sconosciuti a null.
L’età di uno snapshot non dimostra da sola che tutte le transazioni applicative siano recuperabili. Non è una misura reale del tuo RPO.
03 · Non confondere integrità e ripartenza
In Proxmox Backup Server, una verifica del backup controlla l’integrità dei dati di backup. Conserva job, snapshot e risultato rilevante; poi tratta il ripristino e l’accettazione dell’applicazione come verifiche distinte. Questa separazione vale anche quando utilizzi un altro motore di backup.
- Nel riepilogo annota esito del job, integrità verificata, restore effettuato e funzione applicativa: quattro stati distinti.
- Per ogni esito ignoto indica chi deve verificarlo, senza promuoverlo a superato.
- Conserva i riferimenti alle evidenze e prepara le correzioni prima della prova successiva.
Un verbale riutilizzabile, con informazioni sufficienti per ripetere la verifica.
Non sono inclusi comandi di restore, pruning, eliminazione o modifica delle retention.
Documentazione e progetti di origine
Fonti consultate il 14/11/2026. Verifica versione, licenza e compatibilità prima di adottare software. Un repository ufficiale non garantisce assenza di vulnerabilità.
Esempi originali da adattare su sistemi autorizzati e dati dimostrativi. Non eseguiti sui tuoi sistemi; nessuna certificazione o risultato garantito.
Dalla guida a una verifica concreta.
Scegli un servizio e definisci prima della prova cosa dimostra che funziona: accesso, apertura dei dati e operazione applicativa. Conserva tempi ed esiti distinti; l’avvio della macchina è soltanto una delle evidenze.
Risorse utili e progetti ufficiali
- Proxmox Backup — Maintenance
Documentazione pubblica. Verifica, conservazione e manutenzione dei repository: operazioni diverse dal collaudo applicativo.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Veeam — Recovery verification ↗helpcenter.veeam.com
- NIST — Protecting data: guidance for managed service providers ↗csrc.nist.gov
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.