Un sistema che invia centinaia di notifiche può essere meno utile di uno che ne produce poche e azionabili. Un alert deve spiegare quale servizio è a rischio, chi deve occuparsene e cosa controllare per primo. Il conteggio delle email ricevute non misura la qualità del monitoraggio.
Partire dai servizi e dall’impatto
Scegli un servizio concreto, per esempio gestionale, scansione o backup notturno, e identifica l’attività che l’utente deve poter svolgere. Elenca i segnali che descrivono il comportamento osservabile e quelli interni necessari alla diagnosi. Google SRE distingue il controllo dall’esterno delle funzioni viste dall’utente dalle metriche interne del sistema. [1] Servono un referente tecnico, un destinatario operativo e una definizione delle ore effettivamente coperte dal servizio di assistenza.
Distinguere evento, segnale e allarme operativo
Un evento è qualcosa che il sistema registra. Un segnale è una misura utile a comprenderne il comportamento. Un allarme operativo richiede una decisione o un’azione. Confondere questi livelli porta a inviare ogni riga di log a una casella di posta, costringendo il destinatario a ricostruire ogni volta ciò che conta. La raccolta può essere ampia; la notifica deve avere un significato preciso.
Per esempio, un singolo tentativo di accesso fallito può essere registrato senza richiedere un intervento immediato. Una sequenza anomala associata a un’identità critica può richiedere un approfondimento. Le condizioni dipendono dal servizio e dal contesto: non esiste una soglia universale da copiare in tutti gli ambienti. L’importante è scrivere quale ipotesi giustifica la regola e quale controllo il destinatario deve eseguire.
Non eliminare gli eventi che non generano allarmi. Possono essere necessari per la diagnosi o per capire un cambiamento successivo, secondo le politiche di conservazione adottate. La distinzione riduce il rumore senza cancellare le evidenze. Una regola ben progettata separa raccolta, valutazione e consegna, rendendo possibile cambiare il comportamento della notifica senza perdere la storia utile all’analisi.
Progettare un messaggio che aiuti il primo intervento
Per ogni regola scrivi condizione, durata minima, gravità, destinatario e prima verifica. Distingui un evento da registrare, un problema da gestire in orario lavorativo e un’interruzione che richiede intervento immediato. Considera dipendenze e duplicazioni: un collegamento di sede assente può generare molti avvisi secondari. Non sopprimerli indiscriminatamente; conserva la visibilità del problema principale e delle condizioni che richiedono un’azione diversa. Definisci anche cosa accade se il primo destinatario non risponde.
Un avviso dovrebbe identificare servizio, risorsa, condizione e momento. Deve spiegare quale attività potrebbe essere interessata e fornire un riferimento alla procedura pertinente. «Errore critico» senza contesto obbliga il tecnico ad aprire molte console prima di capire se il problema sia urgente. Un titolo specifico permette di assegnare la richiesta alla persona giusta.
Il corpo può includere valore osservato, soglia, durata e ultimo dato valido. Non deve includere segreti o estratti indiscriminati di log. Se serve un dettaglio sensibile, inserisci un collegamento al sistema autorizzato che lo contiene. Controlla che il destinatario abbia accesso effettivo a quel riferimento: un link non apribile durante il turno rende il messaggio meno utile di quanto sembri.
La prima verifica deve essere circoscritta e osservativa. Per un servizio non raggiungibile potrebbe essere controllare se il problema coinvolge una sede o tutti gli utenti; per un job di backup, verificare l’ultimo punto disponibile e l’errore associato. Non trasformare il messaggio in un invito a cancellare dati o disattivare protezioni. Le correzioni richiedono una procedura separata, con autorizzazioni e possibilità di verifica dell’esito.
Usare durata, isteresi e manutenzione con criterio
Una soglia superata per un solo campione può rappresentare un picco normale oppure un problema reale molto breve. La scelta della durata deve dipendere dalla funzione osservata. Aggiungere un ritardo indiscriminato riduce le email ma può nascondere interruzioni importanti. Valuta quindi quale durata abbia significato per l’utente e quale frequenza di campionamento permetta di rilevarla.
La condizione di rientro può essere diversa da quella di attivazione, evitando continui cambi di stato quando una misura oscilla vicino al limite. Questo principio va applicato con criteri espliciti e collaudati. Non assumere che un allarme chiuso significhi causa risolta: potrebbe indicare soltanto che il valore è tornato sotto la soglia. Le ricorrenze restano un elemento da analizzare.
Le finestre di manutenzione devono avere inizio, termine e perimetro. Sopprimere una notifica durante un’attività autorizzata non dovrebbe cancellare la raccolta degli eventi né silenziare servizi estranei. Verifica cosa succede alla scadenza e se gli allarmi ancora attivi vengono ripresentati. Una sospensione dimenticata può lasciare un servizio senza avvisi proprio dopo una modifica che richiederebbe maggiore osservazione.
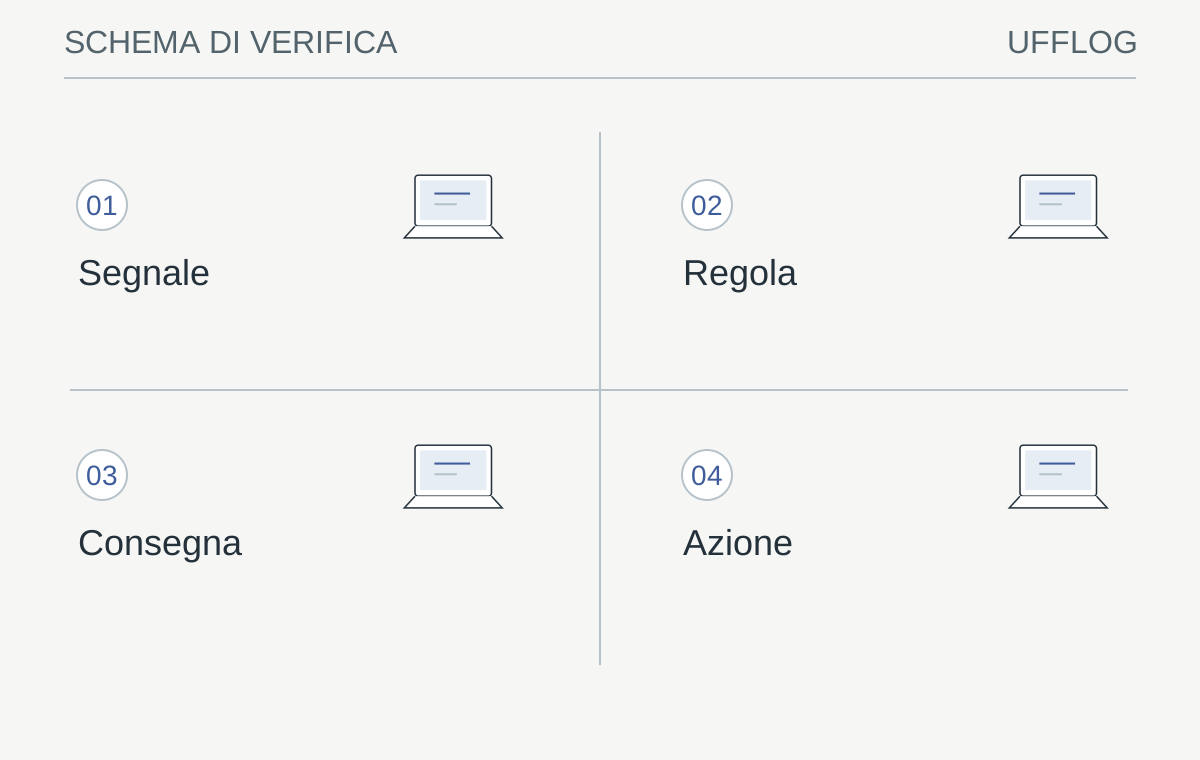
Un allarme ha valore soltanto quando la catena di rilevazione e intervento è verificata.
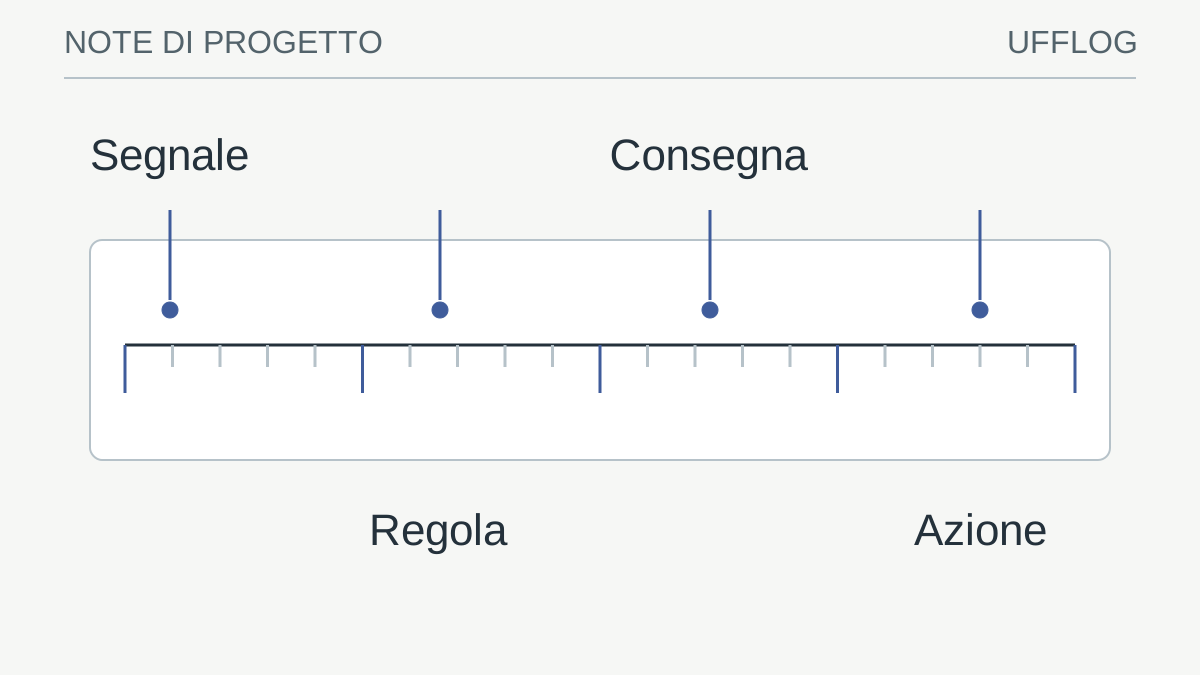
Leggi lo schema
- SegnaleMisura e ultimo campione valido
- RegolaCondizione, durata e impatto sul servizio
- ConsegnaDestinatario e percorso di escalation
- AzionePrima verifica ed esito documentati
La verifica: Il destinatario sa quale verifica eseguire e può accedere alle evidenze?
Se manca un'azione praticabile, rivedi il messaggio o il livello di allarme.
Raggruppare le dipendenze senza perdere i guasti distinti
Un’interruzione di rete può far apparire indisponibili molti dispositivi. Inviare un messaggio per ciascuno può sommergere il destinatario, ma nascondere tutto dietro un unico avviso può perdere informazioni importanti. Il raggruppamento deve riflettere una dipendenza conosciuta, non soltanto la vicinanza temporale degli eventi.
Descrivi quali risorse dipendono dal collegamento, dal sistema di autenticazione o dallo storage condiviso. Quando il componente principale non risponde, il messaggio può elencare i servizi potenzialmente coinvolti e conservare i segnali secondari nel sistema. Se uno di questi mostra un problema indipendente che richiede un’azione diversa, deve poter emergere. La correlazione aiuta a organizzare la diagnosi, non prova automaticamente una causa.
Dopo il recupero della dipendenza principale controlla i servizi a valle. Alcuni potrebbero richiedere una verifica applicativa anche se tornano raggiungibili. Un controllo di rete riuscito non conferma che la coda di lavoro sia stata elaborata o che un database sia coerente. La guida al report mensile mostra come conservare queste differenze senza ridurre l’incidente a un solo periodo di colore rosso.
Verificare anche l’assenza dei dati e la consegna
Usa una funzione di test o una condizione simulata in un ambiente di prova, senza interrompere il servizio reale. Verifica rilevazione, notifica, presa in carico e chiusura, registrando i tempi separatamente. Le soglie dinamiche richiedono dati sufficienti e una fase di apprendimento: Microsoft documenta limiti e requisiti prima che possano segnalare anomalie. [2] Una regola appena creata che non avvisa non è necessariamente una prova di normalità; prevedi controlli statici adeguati per le condizioni essenziali.
Un monitor che smette di ricevere misure non dovrebbe presentare automaticamente uno stato normale. La mancanza di telemetria può dipendere da un agente, un collegamento, un’identità o dalla piattaforma di raccolta. Definisci quanto può essere vecchio l’ultimo dato prima che lo stato diventi sconosciuto e chi deve occuparsi della verifica.
La consegna dell’email non coincide con la presa in carico. Un destinatario può essere assente, una casella può essere filtrata o un gruppo può non avere più membri corretti. Prevedi un percorso di escalation coerente con il servizio concordato e prova periodicamente un messaggio innocuo. Registra separatamente rilevazione, invio, ricezione confermata e azione: sono passaggi diversi della catena.
Se tutti gli avvisi dipendono dalla stessa rete o identità che stanno osservando, chiedi come verrà rilevata la perdita di quella dipendenza. Non occorre duplicare ogni componente senza analisi, ma occorre rendere visibile il punto comune. Per il backup, la guida agli errori e alle notifiche aiuta a verificare che anche l’assenza del job previsto venga considerata, non soltanto il suo eventuale messaggio di errore.
Integrare soglie dinamiche e AI senza delegare la responsabilità
Le soglie dinamiche possono evidenziare deviazioni da un andamento appreso, ma richiedono dati adeguati e una comprensione dei loro limiti. Un nuovo servizio, un cambio di orario o un picco previsto possono rendere il passato poco rappresentativo. La documentazione del prodotto va consultata per conoscere periodo di apprendimento, frequenza delle misure e condizioni non supportate. [2]
Un assistente AI può aiutare a riassumere eventi o proporre collegamenti da verificare. Non dovrebbe inventare una causa, eliminare allarmi senza controllo o ricevere log contenenti segreti. Conserva il riferimento agli eventi originali e distingui la conclusione umana dalle ipotesi prodotte dal modello. L’assenza di una segnalazione AI non è una prova che il servizio sia sano.
Mantieni controlli espliciti per le condizioni essenziali, come assenza prolungata del dato o margine minimo di capacità. La guida alle soglie di capacità spiega perché una previsione deve essere collegata al tempo necessario per intervenire. Rivedi ogni regola dopo incidenti mancati o notifiche inutili, registrando il motivo della modifica. Il successo del monitoraggio si misura nella qualità delle decisioni e nella copertura conosciuta, non nella quantità di automazione dichiarata.
La revisione delle regole dovrebbe includere chi riceve davvero le notifiche. Un tecnico può spiegare che un avviso arriva senza permessi sufficienti per aprire la console; un responsabile può segnalare che il nome della risorsa non identifica la sede. Sono difetti operativi, anche se la condizione matematica della soglia è corretta. Correggere titolo, destinatario o collegamento può migliorare l’intervento senza aggiungere altri sensori.
Conserva una piccola scheda per ogni regola importante: motivo, proprietario, ultima prova e condizioni in cui va riesaminata. La scheda non deve contenere dati sensibili, ma deve rendere comprensibile la scelta a un tecnico che subentra. Quando un servizio cambia orario o architettura, questa informazione aiuta a individuare le regole da aggiornare. Elimina le notifiche obsolete soltanto dopo aver confermato che il servizio sia realmente dismesso o coperto da un controllo sostitutivo. La riduzione del rumore è una modifica del sistema di osservazione e merita la stessa attenzione di una nuova attivazione.
Rivedere rumore, copertura e casi mancati
Analizza gli avvisi senza azione, i problemi segnalati dagli utenti prima del monitoraggio e le notifiche arrivate al destinatario sbagliato. Log Lens aiuta a raggruppare un estratto dei registri, ma non raccoglie telemetria continua e non sostituisce il sistema di allerta. Mantieni uno storico delle modifiche e ripristina la regola precedente se una nuova soglia nasconde un problema reale. Un rapporto utile mostra quali servizi sono coperti, quali no e quale azione ha prodotto ogni allarme significativo: un cruscotto interamente verde è credibile solo se i controlli e i loro limiti sono espliciti.
Dalla guida a una verifica concreta.
Scegli un segnale e collega soglia, destinatario e azione possibile. Prevedi un esito per assenza di dati e duplicazioni; un pannello pieno di notifiche può nascondere proprio il problema che richiede intervento.
Risorse utili e progetti ufficiali
- Prometheus — Alertmanager
Documentazione pubblica. Raggruppamento, instradamento e soppressione degli avvisi con regole esplicite.
- Zabbix
Progetto open source. Monitoraggio da gestire e aggiornare. Software aperto non significa un servizio presidiato già incluso.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Google SRE: monitorare sistemi distribuiti ↗sre.google
- Microsoft: soglie dinamiche di Azure Monitor ↗learn.microsoft.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.