Quando un server rallenta, la prima reazione è confrontare processori, memoria e dischi. Sono elementi necessari, ma rischiano di rispondere alla domanda sbagliata. Il problema può dipendere da un’applicazione, da una rete satura o da una finestra di manutenzione sovrapposta al lavoro. Un investimento robusto parte da misure e relazioni, poi arriva all’hardware.
Misurare durante il lavoro vero
Una fotografia di pochi minuti può perdere il picco che crea difficoltà ogni lunedì o durante la chiusura mensile. La rilevazione deve includere periodi rappresentativi, con attenzione alle attività pianificate: backup, elaborazioni, aggiornamenti e scansioni. Non serve accumulare ogni metrica disponibile; serve collegare i dati a un fenomeno osservato dagli utenti.
CPU, memoria, latenza e attività dello storage, traffico di rete e spazio disponibile vanno letti insieme. Un utilizzo medio basso non esclude attese brevi ma frequenti. Quando possibile si annotano orari e operazioni lente, così da confrontarli con le misure. Il racconto dell’utente diventa una traccia da verificare, non un’impressione da accettare o respingere.
Definisci la frequenza delle misure in relazione al fenomeno. Campioni troppo distanziati possono nascondere picchi brevi; una raccolta troppo dettagliata può produrre dati difficili da gestire senza aggiungere valore. Conserva l’intervallo usato e confronta periodi simili. Se cambia il carico, annotalo invece di attribuire automaticamente il miglioramento a una modifica hardware.
Separa inoltre utilizzo e attesa. Una risorsa può essere poco occupata mentre un’applicazione aspetta un servizio remoto. La diagnosi deve seguire la richiesta lungo la catena e identificare dove trascorre il tempo, evitando di acquistare capacità sul componente più visibile ma non limitante.
Tradurre il sintomo in una domanda misurabile
“Il server è lento” contiene spesso più problemi. Chiedi quale operazione rallenta, per quali utenti, con quale frequenza e rispetto a quale comportamento abituale. Un’apertura lenta della cartella, una stampa in coda e un’elaborazione del database richiedono osservazioni differenti. La domanda iniziale deve essere abbastanza precisa da poter confermare un miglioramento.
Costruisci un piccolo registro di episodi: orario, applicazione, dispositivo, durata osservata e attività concomitanti. Non servono dati personali o contenuti dei documenti. Il registro permette di confrontare segnalazioni e metriche senza trasformare ogni impressione in un’emergenza. Se il problema non si riproduce, conserva l’incertezza e pianifica una raccolta più adatta.
La guida a latenza, banda e perdita aiuta a separare alcuni fenomeni di rete. Il risultato dell’analisi può essere una modifica applicativa o di pianificazione, non necessariamente un nuovo server.
Inventario logico oltre all’hardware
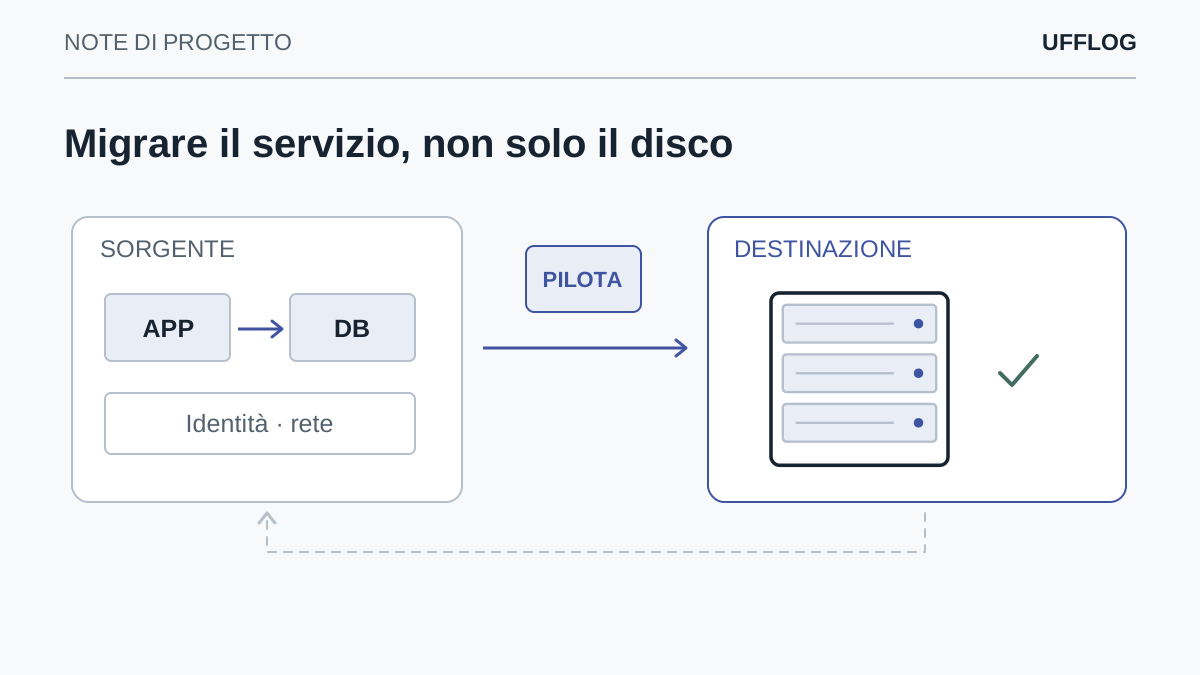
Il numero di macchine non coincide con il numero di servizi. Un gestionale può usare più componenti; un solo server può ospitare funzioni con priorità molto diverse. Occorre identificare applicazioni, proprietari, dipendenze e vincoli di supporto. Questo inventario consente di decidere cosa consolidare, cosa separare e cosa dismettere.
Vanno inclusi apparati di rete, storage, multifunzione e sistemi di autenticazione quando partecipano ai processi. In una PMI una scansione verso una cartella o una stampa di magazzino possono dipendere dal medesimo server che sembra destinato soltanto ai file. Ignorare questi collegamenti rende la sostituzione più rischiosa e la diagnosi meno precisa.
Per ogni servizio prepara una riga con processo sostenuto, utenti, dati, prerequisiti e responsabile. Aggiungi il comportamento in caso di indisponibilità: fermo completo, lavoro ridotto o procedura alternativa. Questa informazione aiuta a distinguere i componenti che devono ripartire subito da quelli che possono attendere.
La mappa deve includere anche l’amministrazione. Se la console di gestione dipende da una VM ospitata sul sistema che deve recuperare, serve sapere come accedere quando quella VM manca. Il progetto non si limita al percorso degli utenti: comprende gli strumenti che permettono ai tecnici di intervenire.
La capacità utile comprende il guasto
Dimensionare soltanto per il funzionamento ordinario lascia aperta la domanda più importante: cosa succede quando una risorsa manca? In un ambiente con ridondanza bisogna verificare il carico residuo e i limiti previsti. Avere due elementi non dimostra, da solo, che ciascuno possa sostenere la modalità alternativa desiderata.
Un esempio ipotetico: due host utilizzati quasi completamente non offrono necessariamente spazio sufficiente per riunire i carichi su uno solo. La soluzione può essere aumentare capacità, ridurre ciò che deve ripartire subito o accettare un servizio degradato definito. L’importante è che la decisione sia visibile e coerente con l’obiettivo, non scoperta durante il fermo.
Una verifica di capacità residua parte dai carichi che devono restare attivi, non dal numero totale di VM. In uno scenario ipotetico, se due host sostengono insieme 160 GB di memoria effettivamente necessaria e ciascuno dispone di 128 GB utilizzabili per i carichi, la perdita di un host richiede una scelta: più capacità, meno carichi prioritari o una modalità degradata concordata. Non basta sommare la memoria installata.
La stessa logica riguarda CPU, storage e rete. Un margine sufficiente sulla memoria non compensa una destinazione dati non raggiungibile. Documenta il collo di bottiglia per lo scenario di guasto scelto e verifica che il comportamento della piattaforma sia coerente.
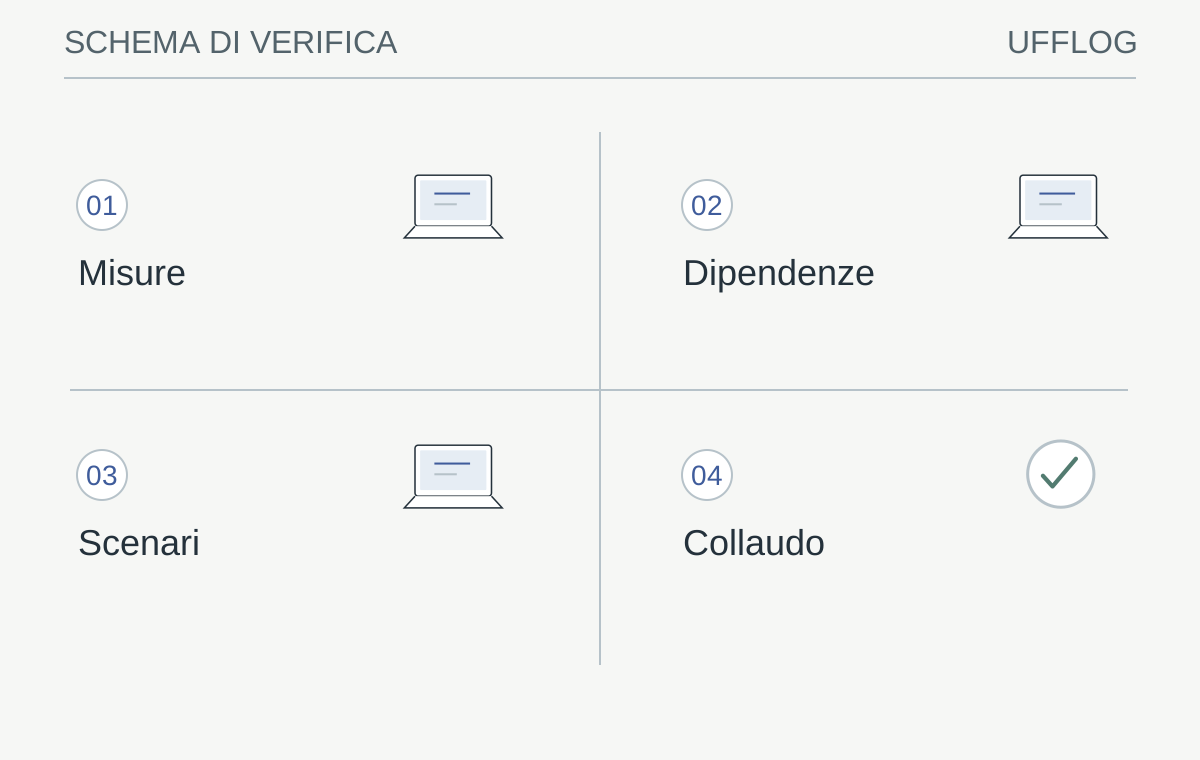
Schema progettuale illustrativo: dati osservati e condizioni operative guidano la decisione.
Leggi lo schema
- MisureOperazioni e periodi rappresentativi
- DipendenzeServizi, identità e gestione
- ScenariCrescita, manutenzione e guasto
- CollaudoRisultato confrontato con l’obiettivo
La verifica: Le risorse residue sostengono i servizi prioritari?
Se no, aumentare capacità o concordare una modalità ridotta verificabile.
Storage e crescita richiedono margine ragionato
Lo spazio libero è un indicatore, ma non descrive prestazioni, scritture temporanee e operazioni di manutenzione. I checkpoint e le attività di backup possono coinvolgere file aggiuntivi e operazioni di consolidamento. La documentazione Microsoft mostra come problemi di storage e checkpoint possano influenzare backup e disponibilità delle VM: questi percorsi devono entrare nel dimensionamento.
La crescita va stimata su dati osservati e su cambiamenti previsti, come un nuovo archivio documentale. Non è utile applicare una percentuale universale senza conoscerne il significato. Conviene distinguere produzione, copie, ambienti di prova e conservazione, verificando poi periodicamente il consumo reale. Le attività di manutenzione del backup richiedono a loro volta risorse e finestre adeguate.
Distingui spazio allocato, realmente occupato e potenzialmente espandibile. Il provisioning sottile può rendere disponibili volumi logici più grandi del consumo attuale, ma non crea capacità fisica quando i dati crescono. Una soglia deve lasciare tempo per intervenire, considerando anche quanto rapidamente può aumentare il consumo durante un’operazione straordinaria.
Per Proxmox Backup Server, pruning e garbage collection svolgono funzioni differenti: rimuovere riferimenti a snapshot non equivale necessariamente a liberare subito tutti i blocchi. [3] Il dimensionamento deve conoscere il ciclo di manutenzione effettivo. Non applicare una previsione lineare ignorando retention, deduplicazione osservata e tempi di recupero dello spazio.
Progettare il percorso di backup e recupero
La capacità della produzione deve essere letta insieme alla protezione dei dati. Un repository sufficientemente grande può comunque non sostenere la finestra di copia o il recupero richiesto. Veeam collega la raccolta dei requisiti alla visione dell’infrastruttura di backup. [1] Occorre conoscere dati, variazioni, conservazione, collegamenti e risorse disponibili durante il ripristino.
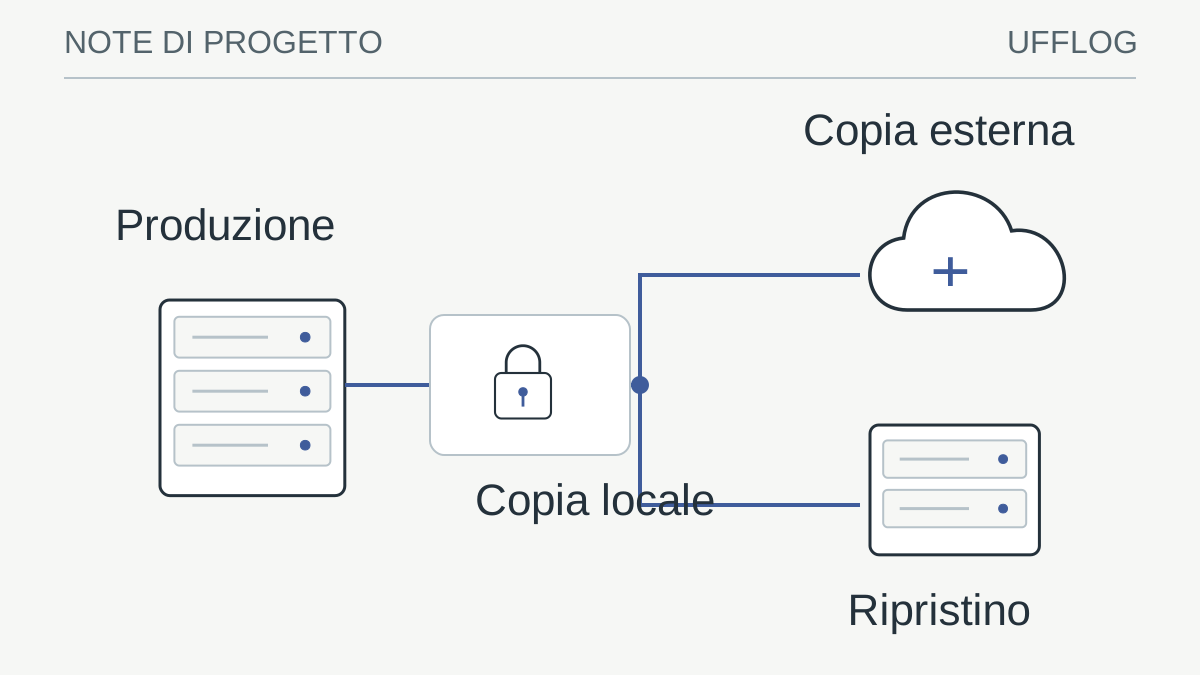
Prepara almeno uno scenario concreto: quale servizio viene recuperato, dove verrà eseguito e quali componenti devono restare disponibili. Se la destinazione di recupero coincide con l’hardware guasto, il progetto ha una dipendenza da risolvere. Una copia cloud può essere utile, ma richiede un percorso di accesso, trasferimento e riattivazione compatibile con l’obiettivo.
Il test di ripristino mette alla prova queste ipotesi. La stima preliminare serve a dimensionare; l’esercizio documentato mostra che cosa accade nel perimetro scelto, comprese attese e passaggi applicativi.
Gestibilità e supporto hanno valore operativo
Server Dell o Lenovo, oppure altre piattaforme coerenti con il progetto, vanno valutati per configurazione, supporto e ciclo di vita del modello scelto. Il marchio non sostituisce la verifica delle caratteristiche effettivamente acquistate. Accesso remoto, ricambi, firmware e responsabilità degli aggiornamenti devono essere leggibili nella proposta.
Anche l’open source richiede gestione: aggiornamenti, competenze, procedure e decisioni sul supporto. Il costo della licenza è una componente del costo complessivo, non una misura di affidabilità. La soluzione migliore è quella che l’azienda può mantenere nel tempo, con persone e processi adeguati alla criticità dei servizi.
Chiedi che la proposta distingua supporto hardware, software e gestione operativa. Una garanzia sul componente non definisce chi analizzerà l’allarme o ripristinerà un servizio. Anche i tempi di ricambio vanno letti nelle condizioni contrattuali, senza trasformarli in un tempo di ripartenza dell’intera azienda.
Il costo complessivo comprende manutenzione, energia, capacità di backup, formazione e prove. Una soluzione con licenze meno costose può richiedere competenze diverse; una piattaforma più integrata può ridurre alcune attività e aumentare altre dipendenze. Il confronto deve usare lo stesso perimetro di servizio, altrimenti due preventivi apparentemente simili descrivono risultati differenti.
Rendere il margine una decisione condivisa
La capacità aggiuntiva ha valore quando copre un’esigenza riconoscibile: crescita, manutenzione, failover o picchi. Scrivi quale scenario giustifica ogni margine importante. Se l’azienda accetta una modalità ridotta durante un guasto, identifica i servizi che restano attivi e quelli sospesi. Questa scelta appartiene al business e deve essere tradotta dall’IT in risorse e procedure.
Un budget limitato può essere distribuito per fasi, ma le dipendenze essenziali non dovrebbero essere lasciate implicite. È utile distinguere requisiti minimi, miglioramenti e capacità futura. La direzione può così valutare il costo di una rinuncia concreta, invece di scegliere tra configurazioni descritte soltanto da quantità di processori e dischi.
La guida RPO, RTO e MTPD collega queste decisioni alla continuità del lavoro. Gli obiettivi devono essere realistici rispetto alle risorse e verificati quando cambiano dati o processi.
Una proposta che spiega le scelte
Il progetto finale dovrebbe contenere situazione iniziale, ipotesi di crescita, limiti, priorità e modalità di recupero. Ogni componente importante deve avere una ragione operativa comprensibile. Un elenco di codici prodotto può essere necessario per acquistare, ma non basta a valutare se l’investimento risolve il problema da cui si è partiti.
Ufficio Lo.Gi.Co. collega infrastruttura, backup e gestione quotidiana. Per iniziare servono inventario, sintomi osservati e obiettivi aziendali, non una configurazione già decisa. Il risultato atteso è una piattaforma proporzionata, monitorabile e recuperabile, con margini motivati e un percorso chiaro per accompagnare la crescita invece di inseguirla a ogni emergenza.
Il collaudo dovrebbe riprendere il problema iniziale. Se l’obiettivo era ridurre l’attesa di un’operazione, ripeti quella misura in condizioni comparabili; se era sostenere un guasto, verifica lo scenario previsto con un piano autorizzato. La consegna non si esaurisce nella conferma che tutti i componenti siano accesi.
Conserva ipotesi e limiti insieme ai risultati. Il progetto può essere adeguato a un numero di utenti e a un tasso di crescita, ma richiedere revisione quando cambia il processo. Una soglia di riesame esplicita consente di pianificare l’evoluzione prima che il margine si esaurisca e di motivare il prossimo investimento con dati confrontabili.
Dalla guida a una verifica concreta.
Parti da una funzione aziendale, come emettere una fattura, e risali a server, rete, identità e storage. Assegna un proprietario a ogni dipendenza; un elenco hardware senza questi legami non spiega l’impatto di un guasto.
Risorse utili e progetti ufficiali
- NetBox Community
Progetto open source. Inventario e modello delle dipendenze di rete. Il repository Community è distinto dai servizi commerciali.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Veeam — Infrastructure overview ↗bp.veeam.com
- Microsoft — VM backup, checkpoint and storage failures ↗learn.microsoft.com
- Proxmox Backup Server — Maintenance ↗pbs.proxmox.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.