La replica può ridurre il lavoro necessario per rendere disponibile una macchina in un ambiente alternativo. Non dimostra però che gli utenti possano raggiungere l’applicazione, che tutte le dipendenze siano presenti o che il punto disponibile sia quello desiderato. Con Hyper-V Replica il test di failover è uno strumento per trasformare queste ipotesi in verifiche osservabili.
Tre operazioni, tre contesti
Microsoft distingue il test di failover, il failover pianificato e quello non pianificato. Il test consente di verificare una copia senza eseguire il passaggio operativo della produzione; il pianificato presuppone condizioni diverse da un guasto improvviso. Trattarli come la stessa operazione porta a descrivere tempi e perdita dati senza considerare lo scenario reale.
La documentazione indica inoltre che la VM di test viene creata con la rete inizialmente disconnessa. È un dettaglio operativo importante: l’ambiente deve essere collegato consapevolmente a una rete appropriata per la prova. Non si deve associare una copia della produzione alla rete aziendale soltanto per semplificare l’accesso durante il test.
Replica, checkpoint e backup non si sostituiscono per nome
La replica sostiene determinati scenari di disponibilità, mentre una storia di backup aiuta a recuperare stati precedenti secondo la politica adottata. Anche i checkpoint hanno funzioni specifiche: Microsoft ricorda che uno snapshot non equivale a un backup completo. Nessuna di queste etichette descrive da sola tutte le esigenze di protezione del servizio.
Il progetto dovrebbe spiegare cosa accade dopo il passaggio: dove proseguono i backup, come viene protetta la nuova produzione e come si gestisce il ritorno. Il failback è una fase da preparare, non una semplice inversione immaginaria del primo comando. I dati scritti durante il funzionamento alternativo devono restare parte della decisione.
Prepara un inventario del servizio replicato
Prima del test descrivi il servizio dal punto di vista dell’utilizzatore: quale operazione deve tornare possibile, con quali dati e per quali persone? Da questa definizione ricava le macchine e le dipendenze necessarie. Una VM applicativa, un database e un sistema di identità possono appartenere allo stesso processo senza condividere lo stesso metodo o punto di replica.
L’inventario dovrebbe comprendere risorse di calcolo, storage, reti virtuali, risoluzione dei nomi, certificati, accessi, licenze e integrazioni. Annota ciò che sarà presente nel test e ciò che resterà escluso. Un’esclusione non invalida automaticamente la prova, purché il risultato venga descritto per il perimetro realmente verificato. Non dichiarare “servizio recuperabile” se hai osservato soltanto il sistema operativo di una macchina.
Per una prova guidata, raccogli le condizioni iniziali in una scheda breve: replica scelta, punto disponibile, dimensione dei dati, rete prevista e responsabile della validazione. Il calcolatore dei tempi di ripristino può aiutare a ragionare sulle fasi, ma non sostituisce le misure della prova. La guida a RTO e RPO chiarisce invece quali obiettivi devono arrivare dal processo aziendale.
Conserva l’elenco accanto al verbale. Se l’applicazione cambia architettura, introduce una nuova dipendenza o sposta un componente nel cloud, il vecchio esito non copre automaticamente il nuovo servizio. Il test deve seguire il sistema effettivamente usato, non una fotografia rimasta immutata nel documento.
Costruisci una sandbox che impedisca effetti indesiderati
Una replica può avviarsi e restare irraggiungibile per gli utenti. Indirizzi, nomi, routing e regole di sicurezza devono essere coerenti con la destinazione. A volte l’applicazione usa riferimenti statici o integrazioni che non compaiono nella configurazione della VM. Il test deve far emergere queste relazioni prima che diventino ostacoli durante un fermo.
Per un esempio ipotetico, il server del gestionale può dipendere da un database replicato e da un servizio di autenticazione non incluso nella prova. Il mancato accesso non prova che la replica sia corrotta: segnala che lo scenario è incompleto. La relazione dovrebbe distinguere il comportamento della macchina dal comportamento dell’intero servizio.
L’isolamento non coincide con il nome della rete virtuale. Occorre verificare a quali destinazioni la VM di test possa davvero accedere, quali servizi possa pubblicare e quali identità possa utilizzare. Un collegamento aggiunto per comodità può consentire alla copia di parlare con la produzione, soprattutto se esistono routing o accessi condivisi che non compaiono nel diagramma iniziale.
Prima dell’avvio, elenca i processi automatici dell’applicazione: invio email, esportazioni, acquisizioni di file, sincronizzazioni, ordini e chiamate a servizi esterni. Concorda con il referente applicativo come renderli innocui nel laboratorio usando configurazioni supportate. Non sostituire questa analisi con la sola convinzione che “nessuno userà la copia”: alcuni comportamenti partono all’avvio o a un orario stabilito.
Definisci inoltre come entrerà il verificatore. Una postazione di test autorizzata, con i servizi necessari al collaudo, permette di valutare il percorso completo senza usare indiscriminatamente la rete ordinaria. L’accesso deve rispettare il perimetro dei dati recuperati; una copia di produzione contiene comunque informazioni che non diventano pubbliche perché si trovano in una sandbox.
Se non puoi dimostrare il confine, fermati prima di collegare la macchina. La documentazione Microsoft spiega il comportamento iniziale della rete nel test di failover; l’architettura delle connessioni aggiunte resta da progettare. [1] Una prova riuscita tecnicamente ma capace di generare effetti sulla produzione non è un collaudo controllato. Registra la verifica dell’isolamento fra i prerequisiti, non come nota aggiunta dopo l’accensione.
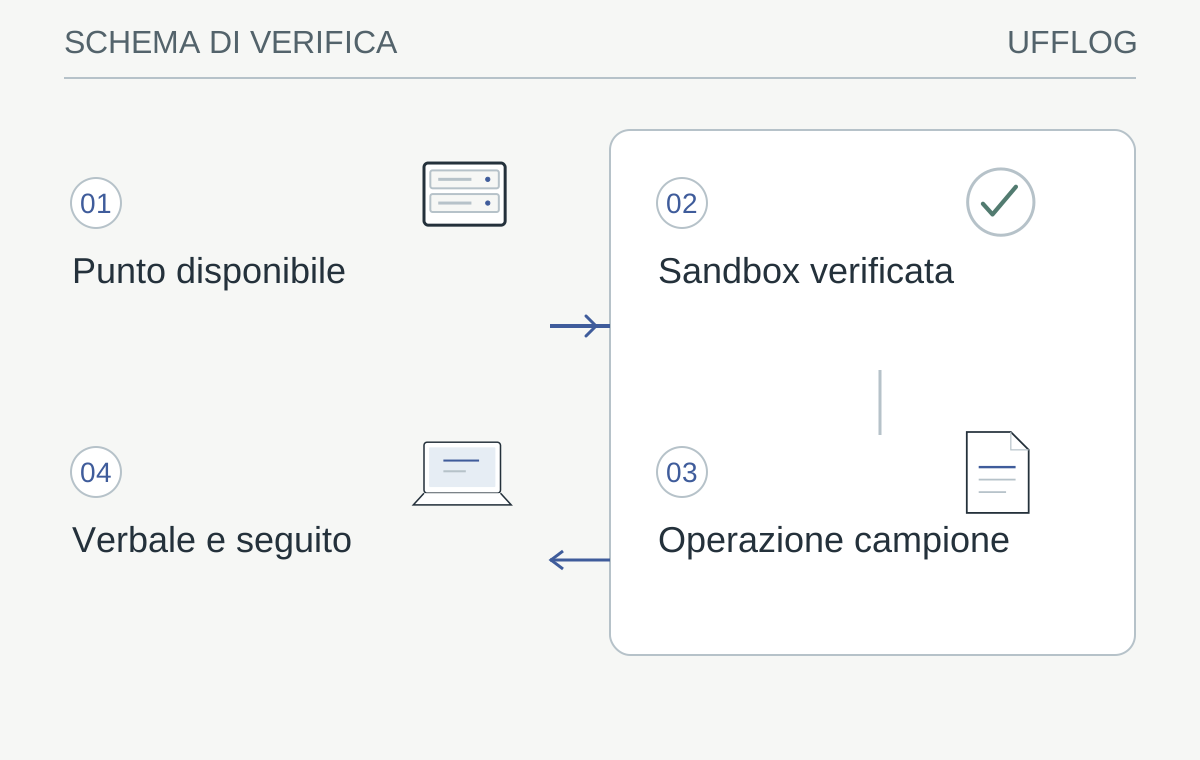
Il percorso rende espliciti punto disponibile, isolamento e accettazione applicativa, senza confondere il test con un failover reale.
Leggi lo schema
- Punto disponibileRiferimenti e coerenza dei componenti
- Sandbox verificataReti e integrazioni senza effetti esterni
- Operazione campioneUtente autorizzato e risultato atteso
- Verbale e seguitoTempi, limiti, anomalie e protezione
La verifica: L’operazione riesce nel perimetro e sui dati attesi?
Se no, separare problema di replica, dipendenze e configurazione applicativa.
Confronta il punto replicato con i dati che il lavoro richiede
Prima di avviare la prova si sceglie il punto disponibile e si registra la sua relazione con i dati di produzione. Si definisce poi un’operazione rappresentativa: leggere una pratica campione, aprire un documento o eseguire una funzione applicativa controllata. L’assenza di errori di avvio è una condizione utile, ma troppo debole come unico criterio.
La verifica deve evitare effetti esterni indesiderati. Una copia che invia email, genera ordini o dialoga con sistemi reali può creare conseguenze operative pur trovandosi in un ambiente di test. Vanno quindi analizzate le integrazioni in uscita e predisposti limiti adeguati. Il progetto di isolamento riguarda il comportamento dell’applicazione oltre alla scheda di rete.
L’RPO è un requisito sul punto temporale recuperabile, non il nome dell’intervallo configurato per la replica. Prima del test osserva quali punti sono effettivamente disponibili e quando sono stati prodotti. Ritardi, interruzioni o problemi applicativi possono rendere il punto utilizzabile diverso da quello atteso. La replica configurata non dimostra, da sola, che tutti i componenti del processo siano coerenti fra loro.
In uno scenario illustrativo, l’applicazione potrebbe essere replicata alle 10:15 mentre il database disponibile rappresenta uno stato precedente. Non basta assegnare a tutto il servizio l’orario più recente. Il responsabile applicativo deve stabilire quali combinazioni siano supportate e come verificare la coerenza. Per questo il verbale riporta il riferimento di ogni componente e l’operazione usata per riconoscere il dato atteso.
Usa record di laboratorio o campioni autorizzati, con criteri chiari. Se il test prevede dati reali, evita di copiarne il contenuto nel rapporto quando bastano riferimenti e risultati. Il verificatore dovrebbe poter dire che una determinata funzione riesce sui dati attesi senza trasformare il verbale in un secondo archivio non governato.
Un punto recente ma incoerente non vale automaticamente più di uno precedente verificato. La scelta va fatta nel processo di recupero, con responsabilità esplicite. La guida alle evidenze di ripristino aiuta a distinguere il dato osservato dalla conclusione che si vuole sostenere.
Misurare la disponibilità del servizio
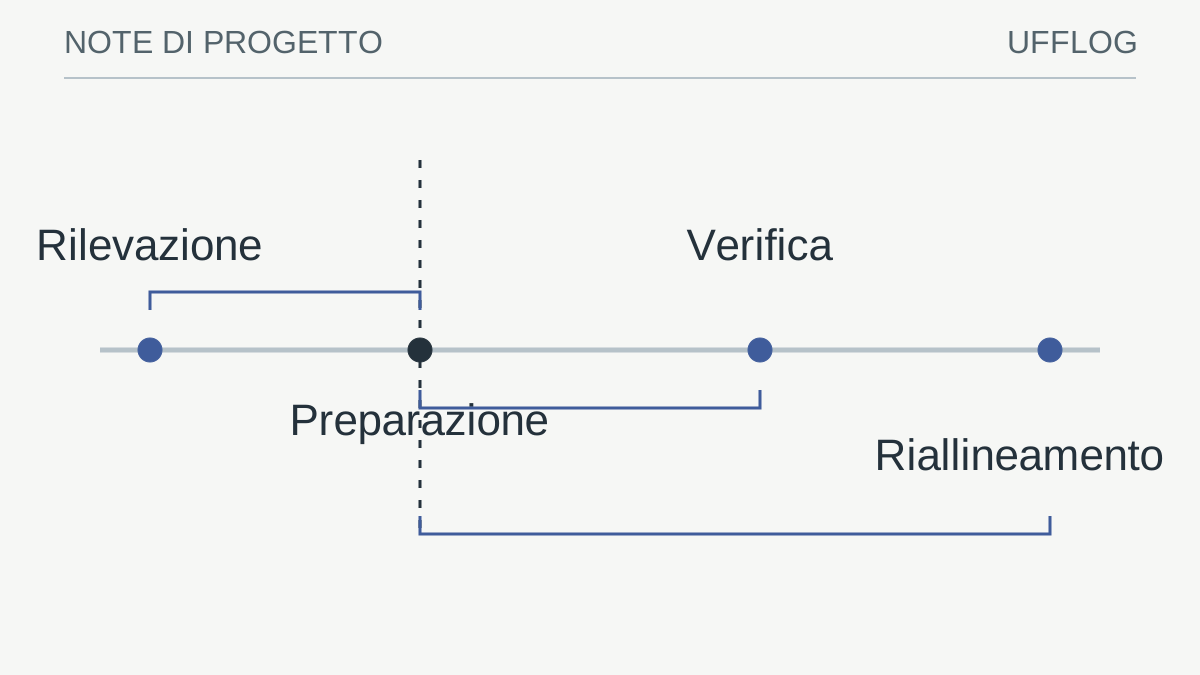
Il tempo di accensione della VM è una misura parziale. Nel verbale conviene registrare preparazione, selezione del punto, avvio, correzioni necessarie e verifica applicativa. Se una fase dipende da un fornitore o da una persona specifica, l’attesa deve essere visibile. Solo così il risultato può orientare investimenti e procedure.
Un test annunciato, con ambiente già predisposto, non rappresenta automaticamente il tempo di risposta a un incidente. Può comunque essere molto utile per misurare la componente tecnica. Separare le condizioni permette di confrontare prove successive senza attribuire al miglioramento dell’infrastruttura ciò che deriva semplicemente da una preparazione diversa.
Chiudere la prova con una correzione utile
Alla fine si registrano esiti, limiti e azioni, si rimuovono le risorse temporanee secondo la procedura e si verifica che la protezione ordinaria sia regolare. Un test che scopre una dipendenza sconosciuta ha prodotto valore. Il passo successivo è correggerla e verificare di nuovo il punto interessato, evitando una relazione che resti soltanto archiviata.
Ufficio Lo.Gi.Co. collega replica, backup e prove isolate al servizio aziendale. Per preparare una valutazione bastano topologia, elenco delle VM replicate, dipendenze note e obiettivi di ripartenza. Da questi elementi si costruisce un test proporzionato, con un risultato che direzione e tecnici possano leggere nello stesso modo.
Valuta il risultato senza trasformare la prova in una promessa
Per rendere confrontabili due test, usa le stesse definizioni. Segna quando il tecnico inizia a preparare il recupero, quando la macchina è avviata, quando il servizio diventa raggiungibile e quando l’utilizzatore lo accetta. Se una dipendenza era già pronta, dichiaralo. Se è stato necessario un intervento manuale non documentato, registralo come lavoro da rendere ripetibile.
Un esempio numerico può chiarire la distinzione: dieci minuti di preparazione, cinque di avvio e quindici di verifiche producono trenta minuti osservati in quelle condizioni. Non descrivono automaticamente il tempo di rilevazione dell’incidente, il reperimento delle persone o la ricostruzione della rete in un guasto reale. Il dato resta utile proprio perché il confine è esplicito.
Chiudi con un elenco breve di anomalie, proprietari e condizioni di ripetizione. Una modifica alla procedura può richiedere di riprovare soltanto la fase interessata; un cambio importante nelle dipendenze può richiedere un nuovo collaudo del servizio. Non moltiplicare prove identiche senza una domanda tecnica, ma non considerare definitivo un esito ottenuto prima di una trasformazione sostanziale dell’ambiente.
Infine verifica che le risorse temporanee siano gestite attraverso le procedure supportate e che replica e backup ordinari risultino regolari. Il recupero non termina con l’accesso riuscito alla copia: comprende anche la protezione del servizio che riprende e la preparazione del successivo passaggio. È questa continuità del metodo a rendere il test spendibile nelle decisioni aziendali.
Dalla guida a una verifica concreta.
Scrivi quali rete e indirizzi userà la VM di prova senza raggiungere la produzione. Definisci una verifica applicativa e la pulizia finale dell’ambiente di test: replica aggiornata e servizio utilizzabile restano risultati distinti.
Risorse utili e progetti ufficiali
- Microsoft — Hyper-V Replica
Documentazione pubblica. Replica, failover e prerequisiti Windows Server; consultazione libera, licenze del prodotto separate.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Microsoft — Hyper-V replication failover ↗learn.microsoft.com
- Microsoft — Using checkpoints ↗learn.microsoft.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.