Cambiare modello può migliorare una risposta e peggiorare il processo che la contiene. Formati, tempi, chiamate agli strumenti e gestione delle ambiguità possono variare anche quando il prompt rimane identico. L’aggiornamento va trattato come una modifica applicativa: con versione identificabile, confronto su casi rappresentativi e possibilità di tornare a una configurazione funzionante.
Distinguere il nome commerciale dalla dipendenza tecnica
Il modello usato dall’applicazione deve essere identificabile nel registro di configurazione. Un nome mostrato in una pagina commerciale non basta a ricostruire quale versione abbia elaborato una richiesta. Verifica l’identificativo accettato dall’API, le condizioni di stabilità e il ciclo di disponibilità documentato dal provider. Non dedurre che un nome senza data sia necessariamente un alias mobile: Anthropic distingue identificativi fissati e alias di comodità, e la convenzione può cambiare fra generazioni. [1]
Registra la scelta nello stesso processo con cui versioni prompt, schemi e codice applicativo. Se un operatore cambia il modello in una console senza aggiornare il riferimento del rilascio, un confronto successivo può attribuire risultati a una configurazione mai effettivamente usata. Le tracce devono indicare la configurazione richiesta e, quando disponibile, l’identità del modello riportata dalla risposta.
La stabilità del modello non rende immutabile l’intera applicazione. Fonti, connettori, librerie e regole possono cambiare indipendentemente. Per questo il confronto deve congelare un insieme coerente di componenti o dichiarare quali differenze siano state introdotte. La domanda utile non è soltanto «quale modello è migliore», ma «quale configurazione produce un risultato accettabile nel nostro flusso».
Costruire un confronto che non premi soltanto lo stile
Una risposta più lunga o più elegante può sembrare migliore anche quando contiene più affermazioni non sostenute. Definisci criteri osservabili: corretta identificazione del problema, uso delle fonti, rispetto del formato, gestione dei dati mancanti e assenza di azioni fuori perimetro. La qualità linguistica è una dimensione, non un sostituto delle altre.
Per un assistente documentale, confronta quali fonti vengono citate e se supportano la conclusione. Per un estrattore, confronta campi, tipi e valori con un riferimento. Per un agente, osserva strumenti chiamati, parametri e condizioni di arresto. Il set di valutazione AI deve contenere esempi rappresentativi e casi in cui la risposta corretta è chiedere chiarimenti o non procedere.
Quando possibile, valuta risultati senza mostrare subito quale modello li abbia prodotti. Questo riduce la tendenza a preferire il nome più recente. Conserva comunque il contesto tecnico necessario a interpretare l’esito. Se un confronto richiede più tentativi, applica lo stesso criterio a entrambe le configurazioni e registra la variabilità: scegliere soltanto la risposta migliore di una serie può nascondere un comportamento instabile nell’uso ordinario.
Provare il contesto lungo e le informazioni decisive lontane
Un confronto con domande brevi può non rappresentare conversazioni estese o documenti lunghi. Prepara casi in cui l’informazione decisiva si trova all’inizio, al centro e alla fine del contesto, mantenendo invariato il compito. Verifica anche contraddizioni e correzioni successive dell’utente. Il risultato deve mostrare quale informazione viene usata, non soltanto se la risposta suona plausibile.
La finestra di contesto dichiarata dal provider non equivale automaticamente alla quantità di materiale che l’applicazione invia. Il backend può troncare messaggi, riassumere la cronologia o selezionare frammenti. Registra questa trasformazione nel confronto: altrimenti un errore attribuito al modello potrebbe dipendere da un dato che non gli è mai arrivato.
Per un assistente operativo verifica che una correzione recente non venga annullata da un riepilogo vecchio. In un caso sintetico, l’utente può cambiare il dispositivo interessato o ritirare una richiesta d’azione. La configurazione nuova deve rispettare il contesto attuale e le approvazioni valide, senza recuperare intenzioni superate da una memoria precedente.
Se il nuovo modello richiede una strategia diversa di contesto, trattala come una modifica applicativa distinta. Confronta il percorso completo e dichiara che cosa è cambiato. Non presentare il vantaggio come una proprietà del solo modello quando dipende anche da recupero, riassunto o selezione delle informazioni.
Verificare schemi, limiti e chiamate agli strumenti
Un output strutturato può cambiare in modi piccoli ma decisivi: campo omesso, valore vuoto invece di nullo, numero rappresentato come testo o proprietà aggiunta. Il parser deve rifiutare ciò che non rispetta il contratto previsto, senza correggere silenziosamente ogni differenza. Durante il confronto usa gli stessi validatori dell’applicazione, perché una risposta leggibile in una chat può fallire quando entra nel processo reale.
Gli strumenti richiedono prove specifiche. Controlla se il nuovo modello propone più chiamate, sceglie un ordine diverso o tenta operazioni quando mancano dati. Un cambiamento può migliorare il completamento di un compito e aumentare consumo, durata o superficie d’azione. La documentazione di Anthropic sugli agenti richiama il valore di flussi semplici e verificabili rispetto alla complessità introdotta senza necessità. [2]
Usa esecutori simulati o ambienti dedicati per le azioni. Il confronto non deve inviare due volte una comunicazione reale soltanto per vedere quale modello la prepara meglio. Se il processo ha una fase di approvazione, verifica che il nuovo modello non cerchi di saltarla o reinterpretarla. Le regole devono essere applicate dal backend, così il cambio del componente linguistico non amplia automaticamente l’autonomia.
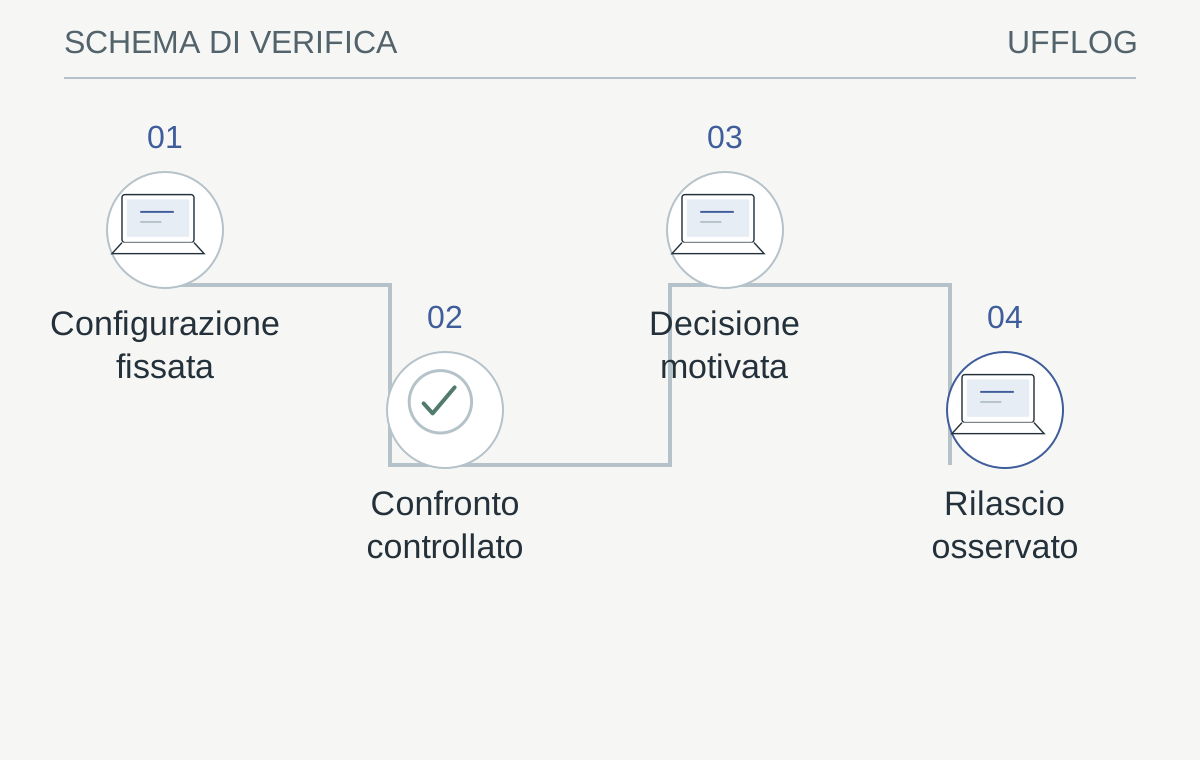
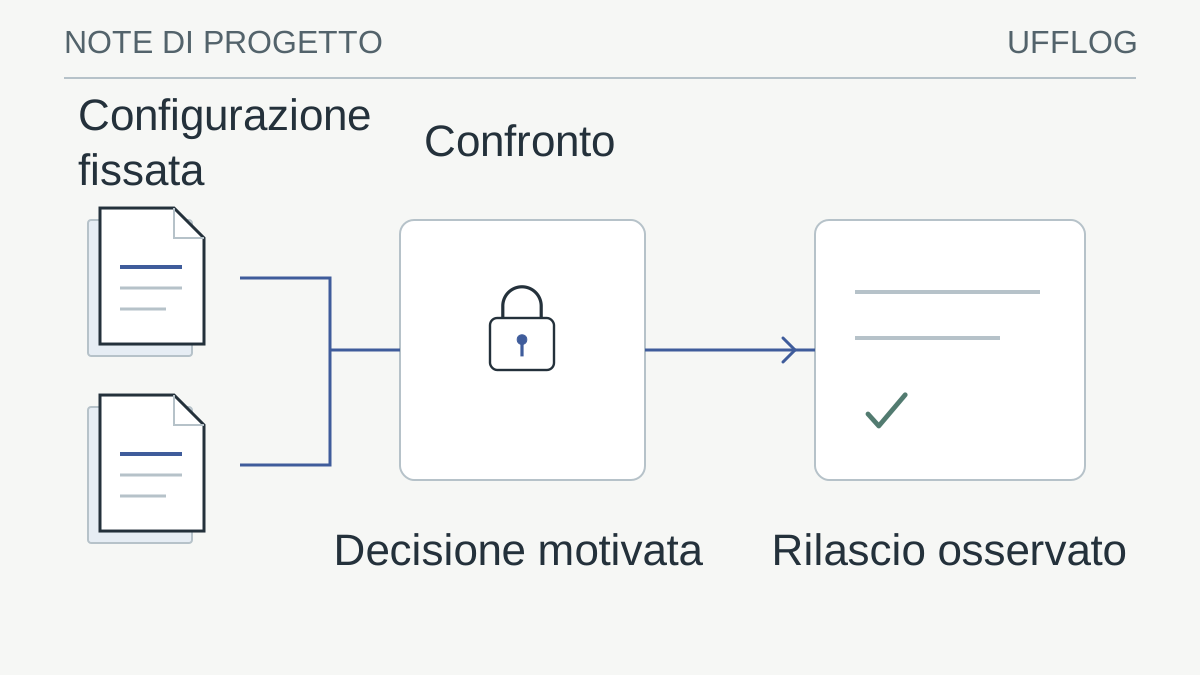
Il confronto usa la stessa attività e criteri decisi prima del test, mantenendo insieme versione tecnica, limiti e piano di ritorno.
Leggi lo schema
- Configurazione fissataModello, prompt, fonti e strumenti
- Confronto controllatoStessi casi, validatori e condizioni
- Decisione motivataQualità, costi e regressioni separati
- Rilascio osservatoPerimetro limitato e ritorno verificabile
La verifica: La nuova configurazione supera i criteri senza regressioni bloccanti?
Se no, correggi o mantieni il riferimento; non compensare violazioni con una media.
Separare i miglioramenti dalle regressioni bloccanti
Una media generale può nascondere un errore critico. Un modello che risolve più domande semplici ma usa una fonte riservata in un caso non è necessariamente accettabile. Definisci un gruppo di condizioni che bloccano il rilascio indipendentemente dal punteggio medio: violazioni dei permessi, azioni non autorizzate, dati inventati in campi decisivi o mancato arresto dopo un errore dell’esecutore.
Per le differenze non critiche, stabilisci chi può accettare il compromesso. Una latenza maggiore potrebbe essere sostenibile in un’analisi approfondita e inaccettabile in un percorso rapido di assistenza. Un output più conciso può ridurre i consumi ma richiedere più domande di chiarimento. La decisione deve essere collegata al servizio e alle aspettative dell’utente, non soltanto alla prestazione dichiarata dal fornitore.
Documenta gli esempi che motivano la scelta. Se una regressione viene accettata, spiega il limite e il controllo compensativo, evitando di farla sparire dal report. Se richiede una modifica del prompt o dello schema, ripeti il confronto sull’intero gruppo pertinente. Correggere un singolo esempio può introdurre un nuovo problema altrove: il test serve proprio a osservare questa relazione.
Misurare il costo per risultato accettato
Il prezzo unitario dei token non descrive da solo la convenienza del cambio. Un modello può consumare meno per chiamata e richiedere più tentativi; un altro può produrre più testo del necessario o chiamare strumenti aggiuntivi. Registra input, output, chiamate, errori e ritentativi, includendo le componenti fatturate dal provider e dall’infrastruttura utilizzata.
Aggiungi il lavoro umano residuo. Se una risposta costa meno ma richiede una revisione più lunga, il beneficio economico può essere inferiore a quanto suggerisce la fattura API. Per il confronto usa un insieme di richieste omogenee e misura il costo totale per pratica accettata, separando casi semplici, complessi e sospesi. Le categorie aiutano a capire se il vantaggio dipende dal tipo di lavoro.
La guida al costo reale dei flussi AI approfondisce il calcolo. Prima del rilascio verifica anche budget, limiti applicativi e comportamento quando il limite viene raggiunto. Un modello differente può cambiare la distribuzione dei consumi, quindi la protezione economica non deve basarsi soltanto su una media osservata in poche richieste di prova.
Preparare un ritorno coerente, non soltanto un nome precedente
Il piano di ritorno deve indicare quali componenti ripristinare insieme. Modello, prompt, schema degli strumenti e gestione del contesto possono essere stati modificati come un’unica versione applicativa. Tornare al vecchio identificativo lasciando un prompt progettato per un comportamento diverso può creare un’ulteriore configurazione mai collaudata.
Verifica che la versione precedente resti disponibile secondo le condizioni del provider. Se non lo è, il piano alternativo può essere un percorso più semplice o il passaggio a una persona, non una promessa di rollback impossibile. Mantieni il servizio capace di dare un esito comprensibile anche senza generazione: stato della pratica, informazioni già raccolte e canale operativo non devono dipendere interamente dal modello.
Durante un rilascio limitato, associa ogni richiesta alla configurazione effettiva e confronta le metriche con il riferimento. Non trasferire conversazioni in corso a un contesto incompatibile senza considerare strumenti già proposti, approvazioni e risultati parziali. Per azioni con effetti esterni, le pratiche sospese devono conservare la propria identità e non ripartire come richieste nuove dopo il cambio.
Rilasciare su un campione senza duplicare gli effetti esterni
Un rilascio limitato deve definire quali richieste usano la nuova configurazione e come si riconoscono nei registri. La scelta non dovrebbe cambiare casualmente durante una pratica che contiene azioni o approvazioni. Mantieni una relazione stabile tra richiesta, configurazione e stato, così il confronto può essere ricostruito senza mescolare risultati di versioni differenti.
Se confronti in parallelo due risposte, gli esecutori delle azioni devono restare simulati o separati dal percorso operativo. Non inviare due email, due ordini o due modifiche per misurare quale modello si comporti meglio. Il confronto può valutare la proposta d’azione e i parametri, lasciando a un solo percorso autorizzato l’effetto reale.
Definisci condizioni di sospensione osservabili: aumento di errori di schema, richieste non completate, costo fuori limite o una regressione critica. Non aspettare che un indicatore medio diventi negativo se un singolo caso attraversa un confine vietato. La persona responsabile deve poter fermare l’estensione e capire quali pratiche sono coinvolte.
Al termine del campione confronta categorie omogenee e limiti dell’osservazione. Un periodo con richieste semplici non dimostra un miglioramento sui casi complessi. Il rilascio completo deve dipendere dalle evidenze pertinenti al servizio, mantenendo un percorso di assistenza per le condizioni ancora non coperte.
Consegnare una decisione ripetibile al responsabile del servizio
Il report finale dovrebbe contenere configurazioni confrontate, campione, criteri, risultati, regressioni e piano di ritorno. Non occorre pubblicare conversazioni riservate: esempi sintetici e riferimenti protetti possono mostrare il metodo. Occorre invece rendere chiaro quali prove sostengano l’adozione e quali aree restino da verificare.
Definisci un controllo dopo il rilascio su traffico reale autorizzato e su nuovi casi emersi. Il campione iniziale non copre ogni futura domanda. Se aumentano errori, richieste ripetute o passaggi alla persona, verifica se dipenda dal modello, dalle fonti o dal cambiamento degli utenti. La registrazione delle versioni consente di distinguere queste ipotesi senza affidarsi alla memoria di chi ha eseguito l’aggiornamento.
Il valutatore di progetto AI aiuta a rivedere ipotesi e lavoro residuo, ma non esegue il confronto tecnico. Il criterio conclusivo resta operativo: la nuova configurazione deve fare meglio il lavoro concordato mantenendo i confini richiesti. Un aggiornamento riuscito lascia evidenze e una via di gestione degli errori, oltre a un nome diverso nella console.
Dalla guida a una verifica concreta.
Esegui il confronto progettuale sullo stesso insieme di casi, includendo formato, citazioni e rifiuti. Definisci in anticipo il limite di regressione accettabile; una risposta più elegante può nascondere un cambiamento operativo importante.
Risorse utili e progetti ufficiali
- Promptfoo
Progetto open source. Framework per valutazioni ripetibili. Le chiamate a modelli esterni possono avere costi e trasferire dati.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Anthropic — Identificativi e versioni dei modelli ↗platform.claude.com
- Anthropic — Progettare agenti e flussi verificabili ↗anthropic.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.