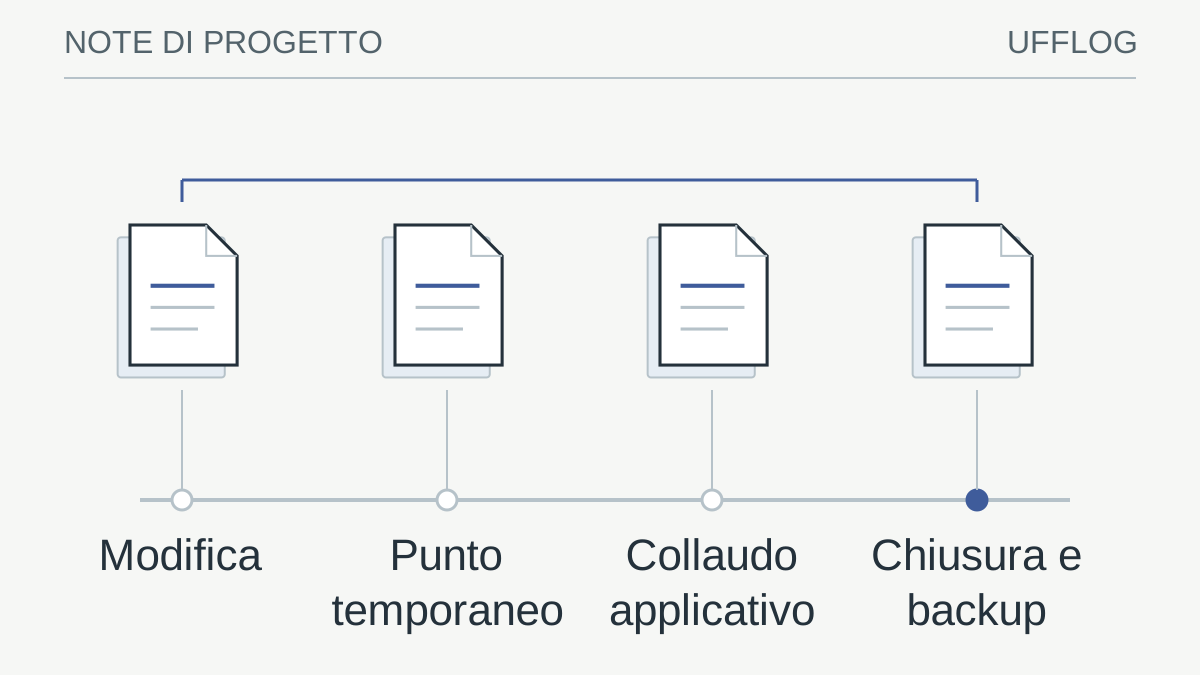
Una finestra di manutenzione efficace comprende preparazione, installazione, verifica e decisione sul ritorno. Non coincide con il tempo necessario a premere “aggiorna”. NIST descrive il patch management come un processo che include identificazione, priorità e verifica dell’installazione; la gestione delle configurazioni conserva il contesto delle modifiche. [1] [2] Il piano deve adattarsi al rischio della patch e al servizio coinvolto.
Definisci perimetro e dipendenze
Elenca prodotti, versioni, aggiornamenti e motivazioni. Leggi requisiti, incompatibilità note e necessità di riavvio nelle fonti ufficiali. Identifica chi usa il servizio, chi può autorizzare il fermo e chi ne verifica il ritorno. Controlla backup recuperabile e accesso di gestione alternativo quando quello ordinario potrebbe interrompersi.
Se l’aggiornamento risolve una vulnerabilità urgente, valuta la rapidità necessaria senza eliminare i controlli essenziali. Una pianificazione proporzionata non è un rinvio indefinito.
La scheda iniziale deve rendere visibile il motivo del cambiamento: sicurezza, correzione di un difetto, compatibilità o funzione richiesta. Non ogni aggiornamento ha la stessa urgenza né lo stesso impatto. La priorità delle vulnerabilità aiuta a distinguere un’esposizione attiva da un intervento ordinario, mantenendo una motivazione tracciabile.
Considera l’intera catena del servizio. Un aggiornamento del sistema operativo può coinvolgere driver, agenti di backup o componenti applicativi; un firmware può richiedere una procedura particolare. Leggi le note del produttore per le versioni effettive e chiedi chiarimenti quando il supporto applicativo è incerto. Non interpretare una compatibilità generica del marchio come approvazione di ogni combinazione.
Definisci infine un referente che possa decidere durante la finestra. Se emerge una condizione inattesa, il tecnico deve sapere chi autorizza la prosecuzione o il ritorno. Lasciare questa decisione a messaggi non letti mentre il servizio è fermo aumenta il rischio di interventi improvvisati. I contatti e la disponibilità fanno parte della preparazione quanto i file di aggiornamento.
Dimensionare la finestra includendo verifica e ritorno
Il tempo disponibile deve coprire preparazione operativa, installazione, eventuali riavvii, collaudo e margine per la decisione. La durata osservata su un sistema simile è un riferimento, non una garanzia. Quantità di dati, prestazioni e dipendenze possono cambiare il risultato. Usa il pilota per aggiornare la stima e dichiara le condizioni che restano incerte.
In uno scenario ipotetico con due ore di finestra, non è ragionevole pianificare due ore di installazione e lasciare la verifica al caso. Il responsabile deve decidere quanta parte riservare a controlli e possibile ritorno, in base al prodotto e al servizio. Se il percorso non entra nella finestra, riduci il perimetro o concorda una finestra diversa.
Comunica agli utenti quando il servizio può essere indisponibile e quale canale usare per urgenze. Evita promesse di rientro al minuto quando le attività hanno variabilità. Una comunicazione precisa sul perimetro è più utile di un orario apparentemente esatto ma non sostenuto dal piano.
Prepara un pilota e il criterio di arresto
Prova su un ambiente rappresentativo o su un gruppo limitato quando possibile. Definisci quali operazioni devono riuscire prima e dopo: autenticazione, stampa, accesso ai dati o esecuzione del gestionale. Non usare soltanto l’avvio del sistema come accettazione.
Stabilisci entro quale momento decidere se proseguire o tornare alla configurazione precedente. Verifica che il rollback sia realmente supportato: aggiornamenti di schema, firmware o database possono avere conseguenze non reversibili con una semplice disinstallazione.
Il pilota deve rappresentare la funzione interessata dal cambiamento. Se aggiorni un agente endpoint, scegli applicazioni e ruoli significativi; se aggiorni un servizio condiviso, prepara un ambiente o un campione adatto con le dipendenze necessarie. Una macchina quasi vuota può confermare l’installazione ma dire poco sulla compatibilità del lavoro reale.
Registra una base prima dell’intervento: versione, stato del servizio e risultato di alcune operazioni. Dopo il cambiamento ripeti le stesse prove. Questa simmetria aiuta a distinguere un problema nuovo da uno già presente. Le anomalie conosciute non devono sparire dal verbale, ma vanno marcate per evitare di attribuirle automaticamente alla patch.
Il criterio di arresto deve essere concreto: una funzione essenziale non disponibile, un errore non previsto o il superamento del tempo entro cui è ancora possibile un ritorno ordinato. Arrestare l’estensione non equivale a interrompere brutalmente un aggiornamento in corso. Segui il comportamento supportato del prodotto e usa il punto decisionale previsto dal piano.
Preparare un recupero adatto al tipo di cambiamento
Un backup è utile soltanto se può sostenere il recupero richiesto. Verifica dati, configurazioni, chiavi e ambiente di destinazione. Per alcune modifiche basta un ritorno di configurazione; per altre serve ricostruire un sistema o gestire dati applicativi. Il metodo deve essere supportato e provato nel perimetro appropriato, evitando di chiamare “rollback” qualsiasi copia disponibile.
Gli aggiornamenti che modificano schema o formato dei dati richiedono attenzione alle scritture successive. Ripristinare una versione precedente può non essere compatibile con dati già trasformati. Coinvolgi il fornitore applicativo e il responsabile del processo per definire blocco delle modifiche, punto di recupero e riconciliazione.
La guida al test di ripristino aiuta a documentare il percorso. Non serve provocare un guasto in produzione per prepararlo: un laboratorio rappresentativo permette di verificare le condizioni prima della finestra e di individuare ciò che deve essere disponibile agli operatori.
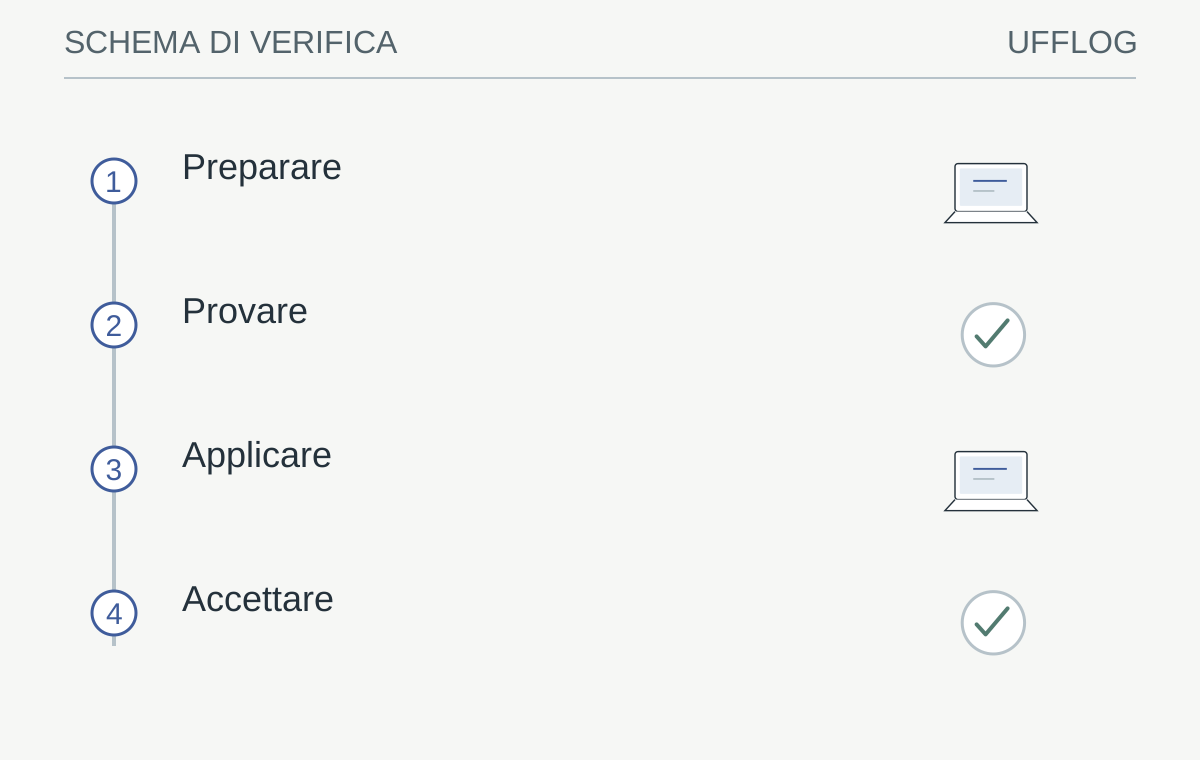
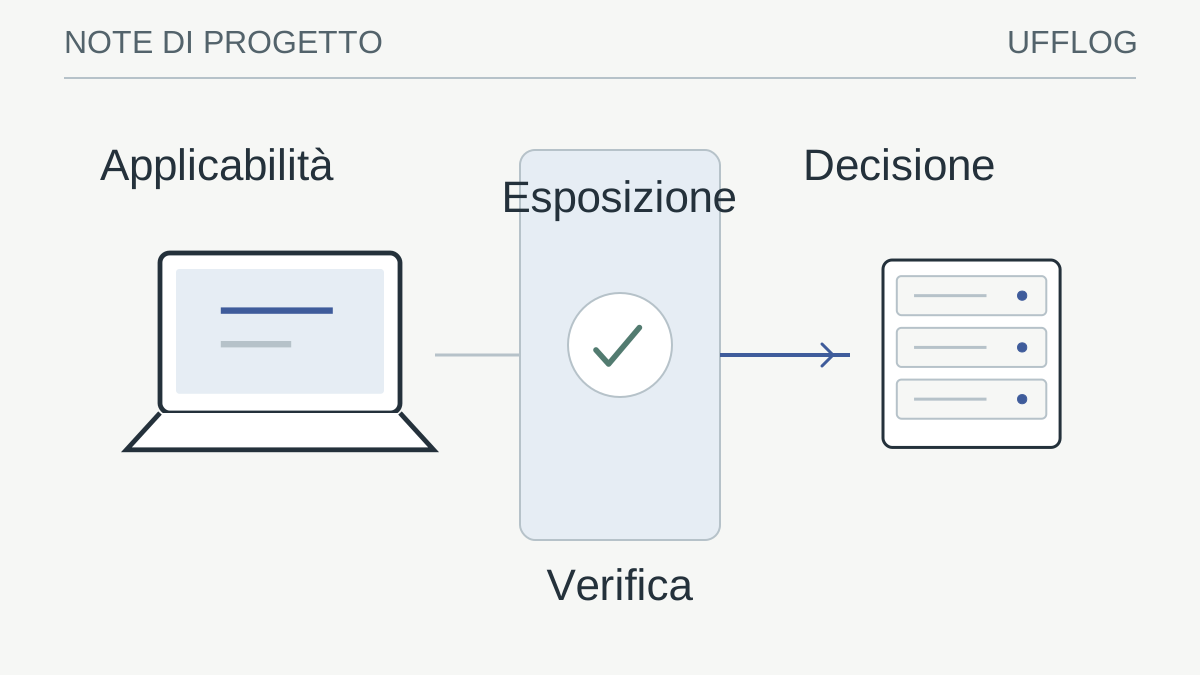
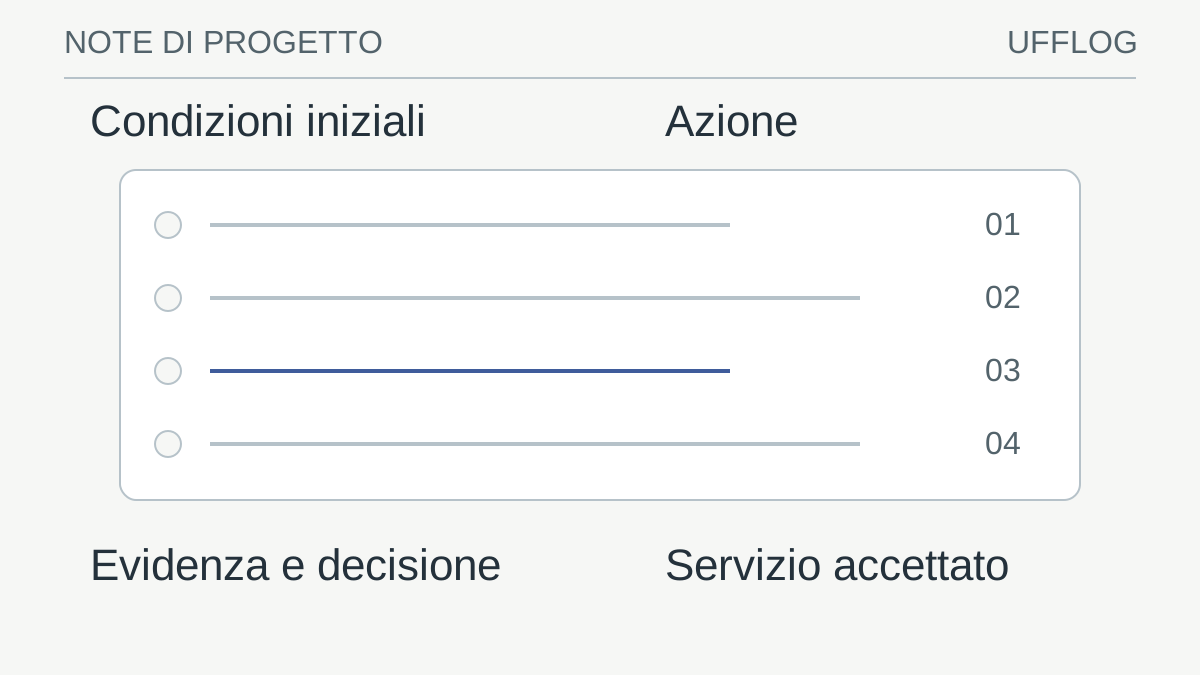
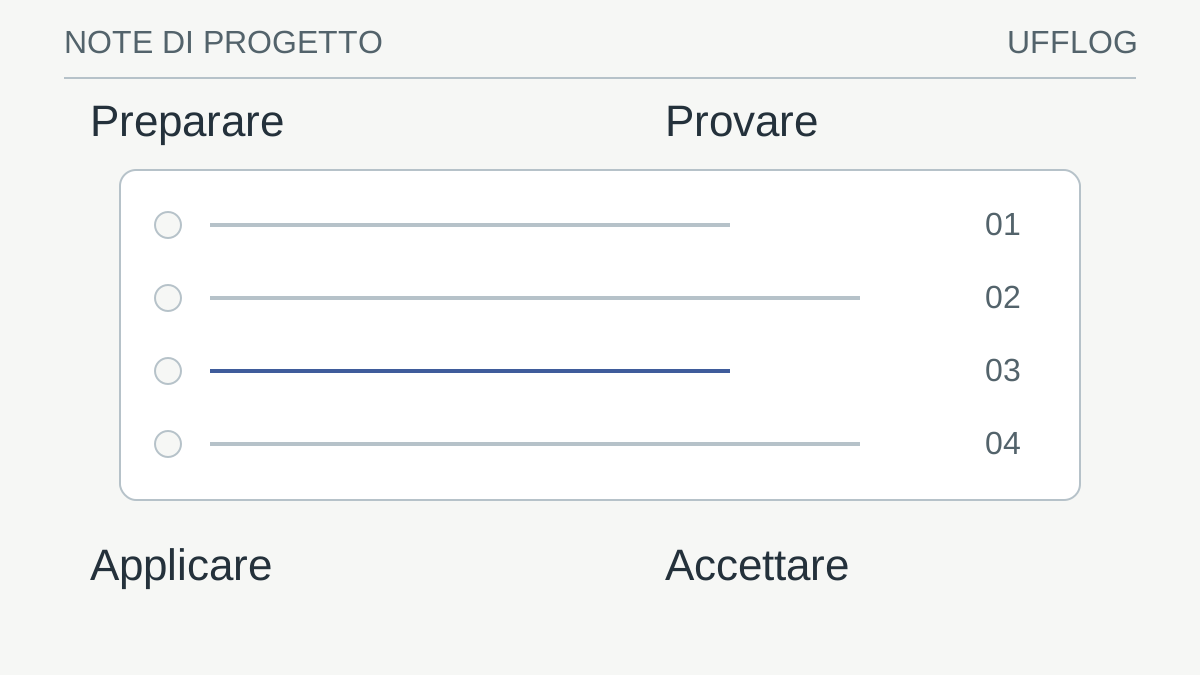
Schema operativo illustrativo: il controllo tecnico viene collegato alla decisione sul servizio.
Leggi lo schema
- PreparareDipendenze, backup e responsabili
- ProvareBaseline e criteri di arresto
- ApplicareSequenza ufficiale e stato registrato
- AccettareVersione, applicazione e job successivi
La verifica: La versione è attiva e il servizio supera le prove?
Se no, applicare il piano approvato e mantenere visibile l’eccezione.
Esegui una sequenza tracciabile
Registra stato iniziale, ora e operatore. Applica aggiornamenti secondo il percorso ufficiale, evitando cambi non necessari nella stessa finestra. Controlla messaggi, riavvii richiesti e dipendenze prima di passare al componente successivo. Non interrompere un’installazione in corso senza indicazioni specifiche.
Se confronti configurazioni JSON, Config Diff può evidenziare differenze strutturali fra esportazioni; non determina se siano sicure né ripristina il sistema. Rivedi le differenze con chi conosce il prodotto.
Mantieni un registro breve delle tappe: controllo iniziale, avvio, messaggi rilevanti, riavvio se richiesto e verifiche. Se più tecnici partecipano, uno coordina la sequenza e gli altri confermano i propri passaggi. Evita modifiche parallele non documentate sullo stesso componente: rendono difficile capire la causa di un errore e possono invalidare il piano di ritorno.
Non aggiungere nella stessa finestra cambiamenti non necessari soltanto perché il sistema è già fermo. Un aggiornamento di sicurezza, una migrazione di storage e una modifica di rete insieme producono più possibili cause di problema. Se il progetto richiede una sequenza combinata, documenta le dipendenze e i punti di verifica tra una fase e l’altra.
Se l’installazione termina con un avviso, leggi il significato prima di proseguire. Un successo con riavvio pendente o una componente non aggiornata può richiedere un’azione specifica. La console centrale e lo stato effettivo sul sistema devono essere coerenti; un semplice contatore di job completati non sostituisce il controllo della versione in uso.
Usare automazione e riavvii con regole osservabili
Gli aggiornamenti automatici riducono attività ripetitive, ma devono avere perimetro, orari e gestione dei fallimenti. Definisci gruppi di distribuzione, condizioni che fermano l’estensione e notifiche utili. Il successo dell’automazione comprende l’esito del servizio dopo il cambiamento, non soltanto l’avvio del job.
Un riavvio notturno può essere adatto ad alcuni sistemi, ma va coordinato con backup, elaborazioni e disponibilità del supporto. Non impostare lo stesso orario su tutti i nodi di un servizio ridondato senza un progetto. La capacità di mantenere il servizio durante manutenzione dipende da risorse residue e sequenza, non dall’etichetta di alta disponibilità.
Il planner cron e fusi orari aiuta a leggere una pianificazione, ma non configura il sistema e non conosce i job già presenti. Verifica fuso orario e comportamento dello scheduler nei cambi d’ora. La pianificazione deve essere confermata dalla piattaforma che eseguirà davvero l’attività.
Accetta il servizio e osserva il periodo successivo
Verifica versioni effettive, assenza di riavvii pendenti e operazioni concordate con il referente. Controlla il successivo backup e gli alert, perché alcuni problemi emergono dopo la finestra. Se il collaudo fallisce, applica il piano di ritorno approvato considerando i dati prodotti nel frattempo. Chiudi con esito, eccezioni e attività residue. Aggiornamenti automatici e riavvii notturni possono far parte del progetto, ma richiedono criteri, osservabilità e gestione dei fallimenti coerenti con il servizio.
L’accettazione deve distinguere esito tecnico e risultato applicativo. Il primo conferma versione e stato dei componenti; il secondo conferma che gli utenti possano completare le operazioni concordate. Una porta aperta o un servizio in esecuzione non dimostrano da soli che il gestionale elabori correttamente un documento o che una scansione raggiunga la cartella prevista.
Il periodo successivo comprende attività che non avvengono subito: job notturni, esportazioni periodiche, backup e monitoraggio. Assegna chi controlla il primo ciclo utile e dove registra l’esito. Se la finestra si chiude prima di quella prova, il rapporto deve distinguere accettazione iniziale e verifica differita. Non nascondere il limite dietro una formula generica di completamento.
Conserva anche le eccezioni e il piano per risolverle. Un aggiornamento rinviato su una macchina deve restare nell’inventario, con motivazione e controllo temporaneo quando necessario. Il servizio di patch management diventa efficace quando ogni sistema ha uno stato spiegabile, non quando tutti i report mostrano verde a costo di escludere i casi difficili.
Misurare la copertura senza perdere i sistemi esclusi
Un report di aggiornamento dovrebbe distinguere sistemi corretti, falliti, non raggiungibili ed esclusi con motivazione. Il denominatore deve essere l’inventario pertinente, non soltanto le macchine che hanno risposto alla console. Un portatile spento per settimane può essere assente dai risultati senza essere aggiornato.
Per ogni esclusione indica proprietario, motivo e data di revisione prevista nel sistema di gestione. Un’applicazione incompatibile richiede un piano con il vendor, non un rinvio permanente senza controllo. Le metriche utili mostrano dove si concentra il rischio e che cosa serve per ridurlo, evitando graduatorie che premiano soltanto il numero di installazioni.
NIST tratta il patch management come manutenzione preventiva dell’organizzazione. [1] Il risultato operativo è un ciclo ripetibile: conoscere, decidere, distribuire, verificare e correggere. La finestra singola è una parte di quel ciclo; il registro delle eccezioni e il controllo dei fallimenti lo mantengono efficace tra un intervento e il successivo.
Dalla guida a una verifica concreta.
Prepara un piccolo lotto pilota con controllo iniziale, modifica prevista, verifica e criterio di ritorno. Assegna anche il controllo del riavvio pendente; una patch scaricata o installata non dimostra che il servizio sia stato collaudato.
Risorse utili e progetti ufficiali
- CISA — KEV data
Dati aperti. Catalogo pubblico di vulnerabilità sfruttate: un criterio di priorità, non un inventario dei propri rischi.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- NIST — Pianificazione del patch management ↗csrc.nist.gov
- NIST — Gestione delle configurazioni ↗csrc.nist.gov
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.