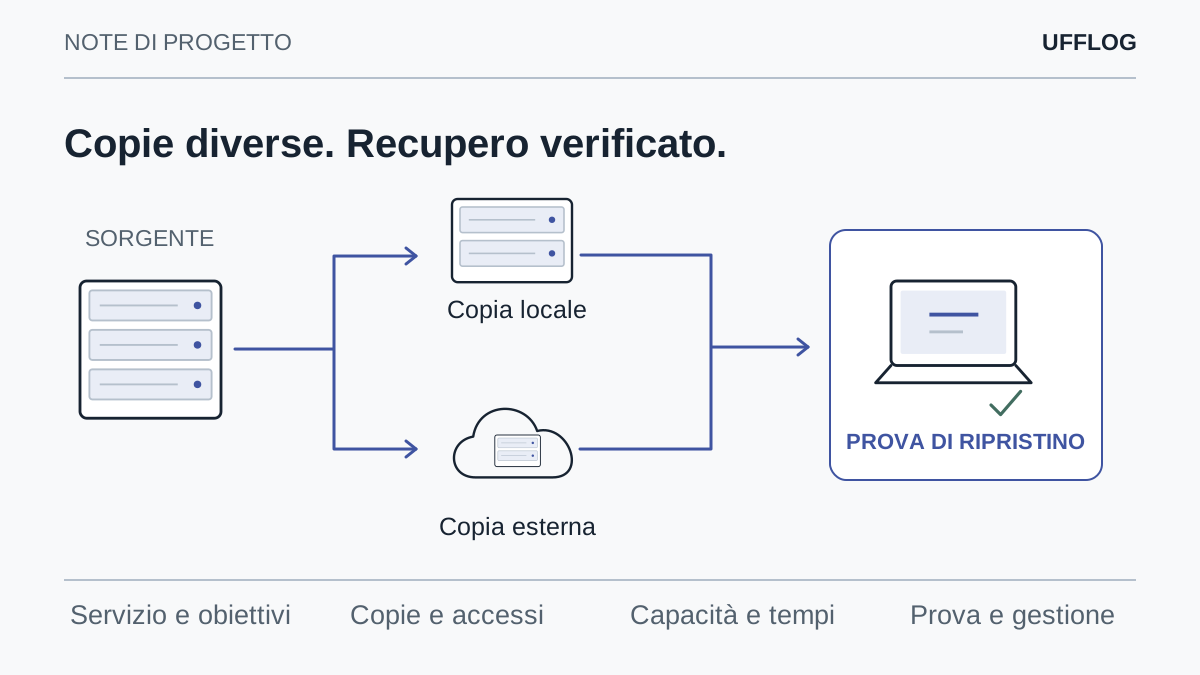
La replica può rendere disponibile un secondo ambiente da avviare quando il primo non è utilizzabile. Il backup conserva punti di recupero secondo una politica dedicata. Sono strumenti complementari: una replica può trasferire anche cancellazioni, cifrature o errori applicativi, e la presenza di un secondo sistema non dimostra che l’utente possa lavorare. La prova deve riguardare il servizio e il percorso di ritorno, non soltanto la macchina.
Disegna lo scenario che vuoi davvero verificare
Una replica serve a mantenere una destinazione utilizzabile in uno scenario concordato. Il test deve quindi partire dall’evento che si vuole affrontare: manutenzione pianificata, perdita dell’host, indisponibilità del sito oppure errore logico sui dati. Lo stesso meccanismo di replica non risolve automaticamente tutti questi casi. Se una cancellazione applicativa viene replicata, la destinazione può contenere lo stesso errore; occorre verificare quali punti precedenti siano disponibili e quale backup separato consenta un recupero ulteriore.
Definisci cosa rimane disponibile nello scenario: rete, identità, DNS, console, chiavi, collegamenti fra sedi e persone autorizzate. Un test in cui tutto il sito principale è attivo può verificare l’avvio della replica, ma lascia aperta la domanda sulla perdita delle sue dipendenze. Non occorre spegnere realmente il sito per chiarire questa lacuna: documenta le condizioni e programma una simulazione controllata delle dipendenze rilevanti.
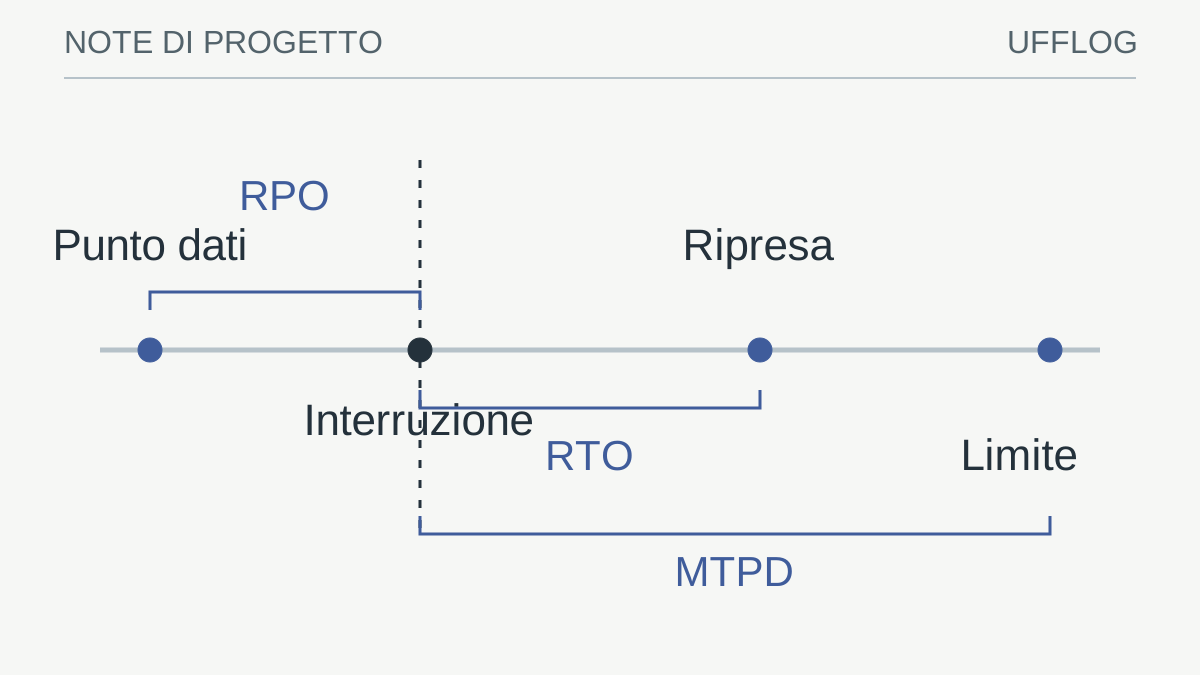
La scheda iniziale deve dichiarare se si prova la macchina replicata, una funzione applicativa o il processo completo di spostamento del servizio. Sono perimetri diversi. Una frase come «disaster recovery testato» è troppo ampia se è stato controllato soltanto l’avvio di una singola VM. Per collegare il test agli obiettivi usa la guida a RPO, RTO e MTPD e concorda quale perdita di aggiornamenti sia accettabile nello scenario.
Definisci quale guasto stai simulando, quale punto vuoi usare e quali operazioni devono riuscire. Raccogli rete, DNS, autenticazione, applicazioni esterne, certificati e modalità di accesso degli utenti. Verifica che la destinazione disponga delle risorse necessarie. Chiarisci l’obiettivo temporale e chi approverà il risultato. Mantieni un backup indipendente recuperabile: il collaudo della replica non lo sostituisce.
Controlla inoltre stato, ritardi ed errori della replica. Un rapporto aggiornato è utile per scegliere il punto di partenza, ma non certifica l’assenza di problemi applicativi. La documentazione Microsoft elenca cause legate a configurazione, connessioni e autenticazione da valutare quando la replica non funziona come previsto. [2]
Distingui test e passaggio reale
In Hyper-V, il test failover crea una VM di prova senza interrompere la replica in corso; per impostazione predefinita la macchina di test non è connessa a una rete. Failover pianificato e non pianificato sono operazioni diverse, con presupposti e conseguenze differenti. Se stai solo collaudando, usa la funzione di test supportata per la versione effettiva e non avviare per errore un passaggio di produzione. [1]
Predisponi una rete isolata e le dipendenze di laboratorio necessarie. Non collegare la copia alla rete reale con indirizzo o identità già in uso. Verifica anche i percorsi verso servizi esterni: una rete separata non è automaticamente priva di accesso a internet o ai sistemi aziendali.
Identifica chi può scrivere sui dati durante la prova
Il rischio principale di una prova poco progettata è avere due copie attive che si comportano come lo stesso servizio. Anche senza utenti connessi, una macchina avviata può eseguire processi, inviare messaggi, aggiornare database esterni o rispondere a richieste. La separazione deve riguardare traffico e comportamenti, non soltanto il nome della VM nella console. Un ambiente isolato richiede una verifica delle connessioni in uscita e delle identità utilizzate.
Prima dell’avvio elenca le destinazioni che potrebbero ricevere scritture: database, sistemi di posta, cartelle di scambio, API, code e servizi di monitoraggio. Associa a ciascuna una decisione di laboratorio: emulare, escludere dalla prova o predisporre una controparte separata. Queste decisioni vengono applicate da persone autorizzate secondo il piano; una guida generale non può fornire una modifica di rete valida per qualsiasi architettura.
Durante il test mantieni leggibile quale copia è primaria per il lavoro reale. Se si tratta di un test failover, gli operatori ordinari continuano a usare la produzione secondo la procedura. Se si tratta di uno spostamento pianificato, il piano deve includere fermo, sincronizzazione e autorizzazione all’avvio della destinazione. Mescolare i due scenari nel medesimo verbale nasconde conseguenze importanti. La sandbox di ripristino offre criteri per preparare il perimetro senza coinvolgere sistemi attivi.
Prima di eseguire il test, identifica i controlli che devono essere positivi e quelli che devono essere negativi. Il servizio di laboratorio deve poter leggere i dati previsti, mentre una destinazione produttiva esclusa non deve ricevere scritture. Questo non autorizza tentativi distruttivi: la verifica dei confini si progetta con il responsabile della rete e con strumenti adatti all’ambiente, usando dati e destinazioni di prova.
Prepara anche un elenco di contatti e un criterio di interruzione. Se appare traffico verso una destinazione inattesa, il passo successivo è sospendere il percorso concordato e chiarire la dipendenza; non aggiungere accessi improvvisati soltanto per far diventare verde la prova. Una correzione del laboratorio può essere legittima, ma deve rimanere distinta dall’esito iniziale e richiedere la ripetizione dei controlli interessati.
Il registro della prova deve mantenere visibili le funzionalità escluse. Se non sono disponibili la controparte di un’API o il servizio di licenza, segnala quali operazioni non possono essere validate. L’avvio della macchina rimane un’evidenza utile, purché la conclusione non estenda quel risultato alla disponibilità dell’intero processo.
Misura il ritardo della replica e la coerenza del punto
L’intervallo configurato della replica è un parametro, non una misura garantita del dato recuperabile. Congestione, arretrati, errori e indisponibilità possono aumentare la distanza dalla sorgente. Prima della prova annota stato, ultimo punto disponibile e condizioni che il software segnala. Non limitarti alla frequenza nominale. Se il punto scelto richiede un recupero applicativo, includi anche quel passaggio nella misura.
In uno scenario illustrativo, una replica pianificata frequentemente può avere accumulato due ore di arretrato. Il test deve usare il punto realmente disponibile e rendere esplicito lo scarto. Recuperare la macchina dimostra un percorso tecnico, ma la valutazione aziendale deve comprendere le operazioni mancanti e la possibilità di ricostruirle. Il responsabile del processo decide se quella perdita è accettabile; il tecnico descrive con precisione i dati osservati.
Per applicazioni distribuite, considera il rapporto fra le copie dei diversi componenti. Due server recuperati da istanti differenti possono richiedere verifiche aggiuntive di coerenza. Non dedurre una consistenza applicativa dal solo fatto che entrambi si avviano. Usa i controlli supportati dai produttori e una transazione di laboratorio concordata. Se non è possibile dimostrare la relazione fra componenti, la conclusione deve restare limitata a ciò che è stato verificato.
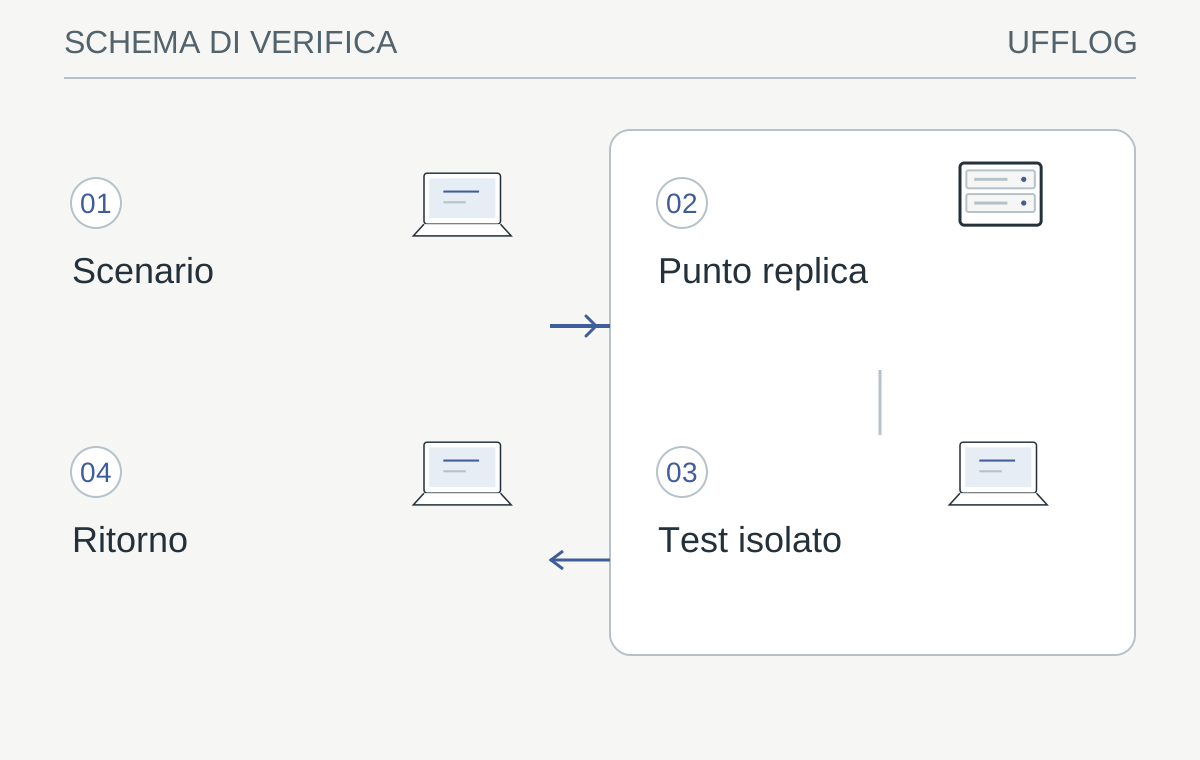
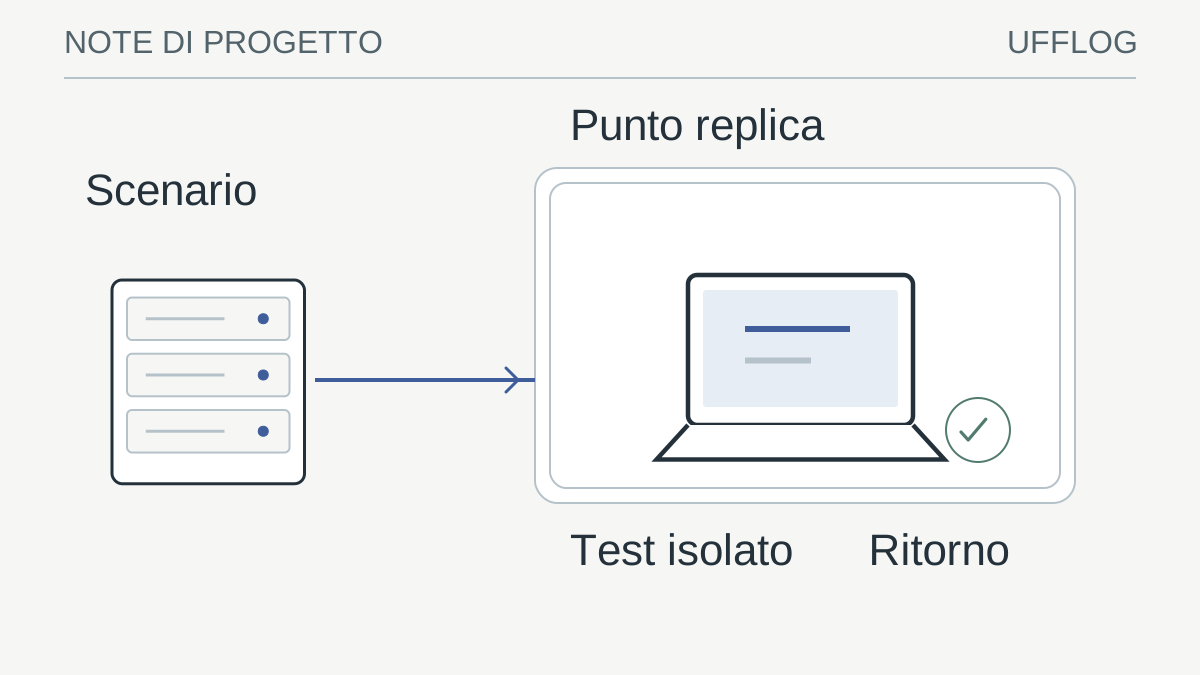
Schema concettuale del percorso di verifica; non rappresenta una prova già eseguita.
Leggi lo schema
- ScenarioDefinisci cosa diventa indisponibile
- Punto replicaMisura ritardo e coerenza dei dati
- Test isolatoValida la funzione senza doppie scritture
- RitornoPrerequisiti e responsabilità del failback
La verifica: La destinazione può operare senza dipendenze non verificate?
Se no, limita l’esito e prepara una prova delle dipendenze mancanti.
Prova il lavoro, non soltanto l’avvio
Annota punto di recupero e orari. Avvia il test, controlla servizi e autenticazione e fai eseguire l’operazione concordata a un referente. Per un gestionale, per esempio, verifica consultazione di un documento e coerenza dei dati associati. Se l’applicazione invia comunicazioni o scrive verso sistemi esterni, usa destinazioni di prova o blocca queste funzioni secondo il piano.
Registra separatamente avvio della VM, disponibilità delle dipendenze e accettazione del servizio. Dichiara le condizioni già predisposte: un laboratorio con rete e identità pronte non misura il tempo necessario a ricostruirle durante un incidente. Verifica anche il dato effettivamente disponibile rispetto all’RPO concordato.
Prova anche il ritorno, senza improvvisarlo
Il failback è una parte del piano, non una conseguenza automatica del failover. Dopo che gli utenti hanno lavorato sulla destinazione, i dati più recenti potrebbero trovarsi lì. Tornare alla sorgente originaria senza una strategia di riconciliazione può perdere aggiornamenti o creare divergenze. In una simulazione questa domanda va affrontata prima dell’avvio, anche quando non si esegue un vero spostamento del servizio.
Identifica come il prodotto gestisce direzione della replica, sincronizzazione e punti di ritorno. Microsoft distingue test, failover pianificato e non pianificato; le relative procedure hanno prerequisiti ed effetti diversi. [1] Non copiare la sequenza di un prodotto in un altro e non ricavare una procedura operativa da un diagramma generico. Versione, piattaforma, stato della sorgente e destinazioni disponibili influenzano la scelta.
Nel piano di prova indica chi autorizza il ritorno e quali controlli lo precedono: integrità, aggiornamenti attesi, accessi, prestazioni minime e disponibilità della sorgente. Se il test non include il failback, dichiaralo come attività non verificata. Una conclusione precisa può essere «avvio isolato della replica e consultazione del campione riusciti; ritorno alla sorgente escluso». È più utile di una formula complessiva che suggerisca una copertura inesistente.
Chiudi il test e controlla lo stato
Raccogli le evidenze prima della rimozione delle risorse temporanee. In Hyper-V la chiusura del test rimuove la VM di prova: non usarla per conservare registrazioni che devono diventare definitive. [1] Esegui la chiusura supportata, verifica la continuità della replica e registra anomalie e azioni correttive. Non lasciare copie duplicate o accessi temporanei attivi.
Conserva una mappa dei risultati e delle eccezioni
Il verbale della replica dovrebbe collegare scenario, punto scelto, dipendenze, attività dell’utilizzatore e risultato. Inserisci gli orari con fuso, la fase che ha richiesto più tempo e le preparazioni già disponibili. Confronta il tempo totale con l’obiettivo, senza cancellare dal conteggio le attese solo perché non sono operazioni del software. Se una parte è simulata o esclusa, deve essere riconoscibile anche nel riepilogo per la direzione.
Classifica le anomalie per decisione necessaria. Un ritardo costante può richiedere una revisione di banda o carico; un accesso mancante può richiedere una responsabilità diversa; un errore replicato può richiedere una conservazione indipendente. Evita di trasformare ogni problema in una richiesta di maggiore potenza hardware. Il piano di continuità comprende persone, configurazioni, copie e tempi: un collo di bottiglia può trovarsi in qualunque punto.
Infine verifica che la chiusura del test non lasci copie di laboratorio attive, regole temporanee o monitoraggi ambigui. La rimozione segue la procedura approvata e deve preservare le evidenze utili. Il test di ripristino da backup rimane un percorso complementare: replica e backup rispondono a domande diverse e diventano più efficaci quando i rispettivi limiti sono documentati nello stesso disegno di resilienza.
Dalla guida a una verifica concreta.
Prepara due elenchi: dipendenze necessarie per partire e condizioni per tornare al sito iniziale. La prova deve verificare entrambi, inclusa la gestione dei dati creati durante il funzionamento sul sito secondario.
Risorse utili e progetti ufficiali
- Microsoft — Hyper-V Replica
Documentazione pubblica. Replica, failover e prerequisiti Windows Server; consultazione libera, licenze del prodotto separate.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- Microsoft — Failover di una VM con Hyper-V Replica ↗learn.microsoft.com
- Microsoft — Risoluzione dei problemi di Hyper-V Replica ↗learn.microsoft.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.