Un sistema EDR raccoglie elementi sul comportamento degli endpoint e sostiene rilevazione, analisi e risposta. Ma l’acquisto di una funzione non decide chi leggerà l’allarme, con quale priorità e con quali autorizzazioni. Per una PMI il valore del servizio nasce quando tecnologia e responsabilità operative sono definite insieme. La domanda decisiva arriva dopo il primo avviso: che cosa accade adesso?
Separare prevenzione, rilevamento e decisione
Antivirus, EDR e servizio di risposta descrivono livelli differenti, anche quando vengono acquistati nella stessa offerta. La prevenzione prova a impedire determinate attività; il rilevamento porta all’attenzione comportamenti da valutare; la risposta modifica lo stato dell’ambiente sulla base delle autorizzazioni disponibili. Un agente installato può contribuire a più livelli, ma non sostituisce la persona o il servizio che decide che cosa fare quando l’esito è ambiguo.
In una valutazione commerciale conviene trasformare i nomi delle funzioni in domande osservabili. Quali sistemi operativi sono coperti? Per quanto tempo sono consultabili gli eventi? È possibile isolare un endpoint mantenendo il collegamento alla console? Chi può autorizzare quella funzione e su quali dispositivi? Le risposte devono riferirsi alla specifica versione, licenza e configurazione. Le pagine ThreatDown e WatchGuard sono punti di partenza per verificare il perimetro dei prodotti, non una descrizione automatica del servizio acquistato. [1] [2]
Un esempio ipotetico: un alert segnala che un programma amministrativo ha modificato molti file. Può trattarsi di un aggiornamento autorizzato oppure di un comportamento ostile. L’operatore deve confrontare processo, origine, identità, dispositivo e attività prevista. Bloccare indiscriminatamente tutti i programmi amministrativi può fermare anche il lavoro legittimo; ignorarli tutti lascia una zona cieca. La qualità sta nella capacità di distinguere, documentare e correggere il criterio.
Riconciliare inventario e copertura prima degli allarmi
Parti dall’elenco dei dispositivi che devono essere protetti, poi confrontalo con ciò che la console osserva. Le due fonti rispondono a domande diverse: l’inventario descrive il perimetro atteso, la console mostra gli agenti conosciuti e il loro stato disponibile. Se una macchina non è mai stata registrata, potrebbe non apparire affatto fra gli errori della console. Il numero di licenze acquistate non risolve questa differenza.
Per ogni endpoint associa un identificativo stabile, il ruolo operativo e il referente. Verifica sistema operativo supportato, policy assegnata, versione dell’agente e ultimo contatto secondo le informazioni offerte dal prodotto. Non trasformare un dato vecchio in una conferma attuale: un portatile non collegato da settimane richiede una classificazione diversa da un server che comunica regolarmente. La granularità dei controlli dipende dalle funzioni e dalla licenza adottate.
Riconcilia anche duplicati e sostituzioni. Una macchina reinstallata può lasciare una voce precedente; un computer consegnato a un altro reparto può mantenere una policy non più pertinente. Prima di eliminare record, verifica quale dispositivo rappresentano e quali informazioni occorre conservare. Una pulizia cosmetica della console può nascondere il problema invece di risolverlo.
L’esito utile è un elenco di differenze con azioni assegnate: installazione mancante, associazione errata, sistema non supportato o dispositivo da dismettere. Per i sistemi che non possono ricevere l’agente previsto, documenta il limite e il percorso tecnico da valutare. Non contarli come protetti solo perché si trovano nella stessa rete di altri endpoint. Questa base rende attendibile ogni successiva percentuale di copertura e indica dove intervenire prima che arrivi un allarme.
Preparare una scheda di triage e preservare le evidenze
Quando arriva un evento, la prima lettura deve poter ricostruire il contesto senza cercare in molte conversazioni. Prepara una scheda con riferimento dell’alert, dispositivo, orario, identità coinvolta, processo osservato e attività aziendale prevista. Aggiungi la fonte delle informazioni e ciò che manca. Il caso non diventa benigno perché il nome del programma è familiare, né diventa confermato soltanto perché la console gli assegna un colore acceso.
Confronta il comportamento con cambiamenti autorizzati e ruolo della macchina. Un intervento amministrativo pianificato può spiegare parte degli eventi, ma deve corrispondere a operatore, finestra e azioni effettive. Se questi elementi non coincidono, mantieni aperta la valutazione e applica la procedura di escalation. La scheda deve distinguere osservazioni, ipotesi e decisioni: mescolarle rende difficile capire che cosa è stato realmente verificato.
Preserva i riferimenti necessari all’analisi nei sistemi autorizzati. Non cancellare file o cronologie per “ripulire” prima che il responsabile abbia deciso come procedere. Evita anche di caricare log integrali, documenti o campioni sospetti in servizi pubblici per ottenere un parere rapido. Nei rapporti operativi condividi soltanto i dettagli pertinenti, mantenendo accessi e tempi di conservazione coerenti con il processo aziendale.
Il passaggio al livello successivo dovrebbe includere una domanda precisa: confermare l’origine di un processo, valutare un contenimento o verificare altre macchine correlate. Un’escalation con contesto riduce i tempi più di un inoltro generico dell’allarme. Registra chi prende in carico il caso e quale riscontro è atteso; la presenza di una notifica inviata non dimostra che qualcuno stia già lavorando sull’evento.
Disegnare una matrice di risposta per tipo di dispositivo
La stessa azione ha conseguenze diverse su un portatile commerciale e su un server che sostiene il gestionale. Definisci almeno tre classi: postazioni ordinarie, dispositivi con funzioni operative particolari e sistemi che erogano servizi condivisi. Per ciascuna identifica il proprietario del processo, la sostituzione disponibile e l’effetto di un isolamento. La matrice deve essere abbastanza breve da usare durante un allarme, senza diventare una lista di eccezioni impossibile da mantenere.
Per una postazione può essere accettabile un isolamento immediato secondo policy, seguito da contatto con l’utente. Per un server applicativo serve valutare anche dipendenze, accessi alternativi e impatto sull’operatività; questo non significa attendere indefinitamente quando il danno si sta propagando. Significa aver concordato prima chi assume la decisione e quali segnali fanno scattare l’escalation. Nessuna guida generica può scegliere al posto del responsabile dell’incidente.
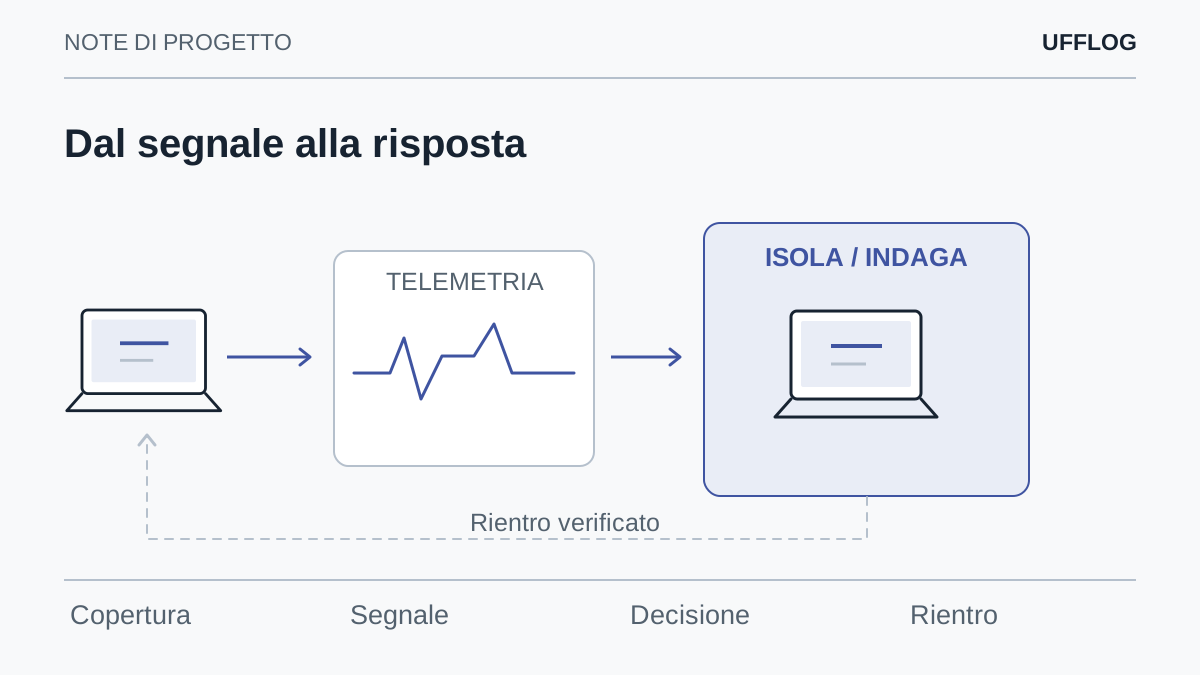
Prepara un canale per raggiungere la persona interessata fuori dal dispositivo isolato. Un messaggio inviato soltanto alla sua posta aziendale può non arrivare. Registra inoltre come riabilitare il sistema dopo la verifica, chi approva il rientro e quali controlli sono necessari. L’isolamento è una misura temporanea di contenimento; non dimostra da solo che la causa sia stata eliminata. Per il passaggio successivo usa il percorso sulla ripartenza dopo ransomware.
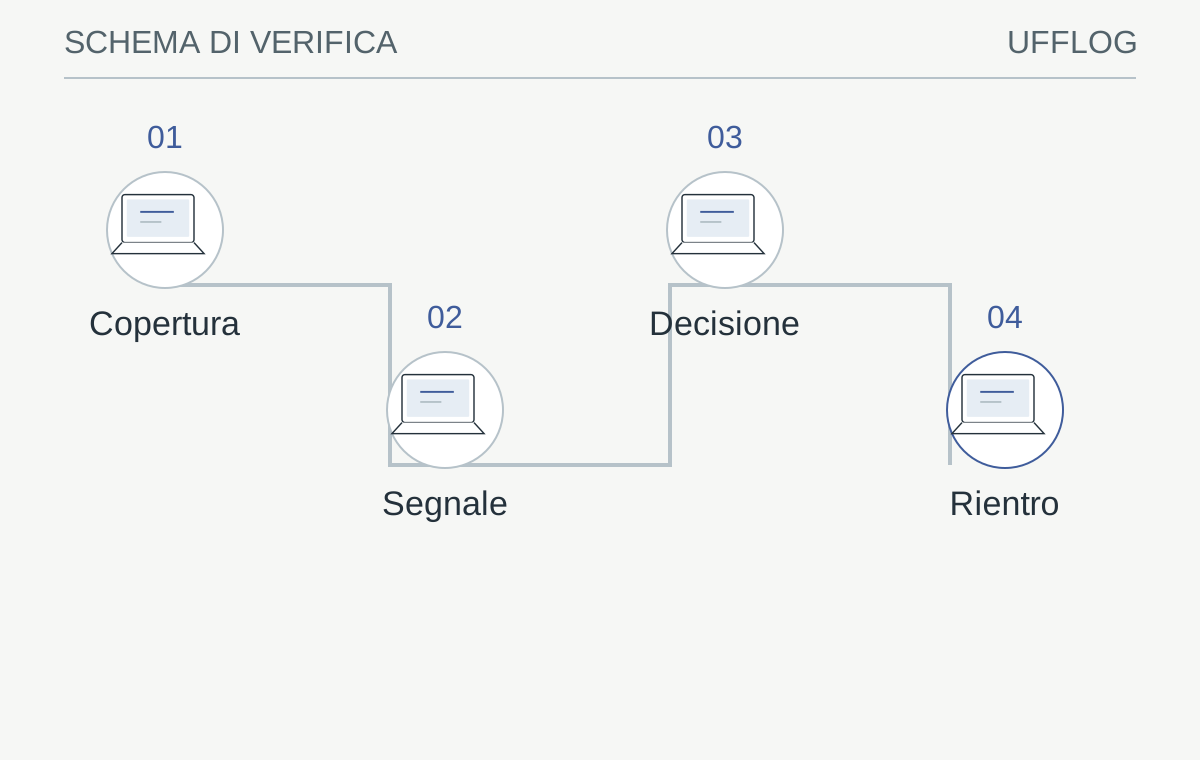
Schema operativo illustrativo: dal requisito alla verifica documentata, con un punto di arresto se manca una condizione essenziale.
Leggi lo schema
- CoperturaInventario, agenti e policy coerenti
- SegnaleEvento contestualizzato sul dispositivo
- DecisioneResponsabile e azione autorizzata
- RientroVerifica della causa e del servizio
La verifica: L’evento ha un responsabile e una decisione motivata?
Se manca, l’alert resta aperto: la presenza dell’agente non basta.
Collaudare notifica e automazione con eventi sintetici
Prima di affidare una risposta a una regola, prepara una prova su un endpoint dedicato e secondo le modalità supportate dal prodotto. Usa eventi sintetici o procedure di test documentate, senza introdurre malware reale o cifrare dati per dimostrare che il servizio reagisce. Concorda il perimetro con il responsabile e segnala la finestra a chi riceverà gli avvisi, così il collaudo non viene confuso con un incidente inatteso.
Scrivi la catena attesa: evento osservato, alert creato, notifica consegnata, operatore informato e azione autorizzata. Ogni passaggio produce un’evidenza diversa. Un messaggio arrivato alla casella corretta non prova che sia stato letto; un comando inviato dalla console non prova che l’endpoint lo abbia eseguito. Il test deve verificare l’esito nel punto in cui cambia realmente lo stato del sistema.
Se è prevista un’azione automatica, controlla che coinvolga il dispositivo e la policy corretti. Valuta anche che cosa accade quando il dispositivo non risponde o il servizio di notifica è indisponibile. Non occorre provocare un guasto generale: alcuni passaggi possono essere esercitati come scenario documentale, dichiarando esplicitamente ciò che non è stato eseguito. Il verbale deve separare simulazione e riscontro tecnico osservato.
Concludi con il ritorno alla condizione autorizzata e con una decisione sulle lacune. Una regola troppo ampia richiede una correzione prima dell’estensione; un contatto non raggiungibile richiede un aggiornamento del processo. Non compensare un collaudo incompleto promettendo interventi automatici universali. Il valore della prova è conoscere precisamente che cosa il servizio riesce a fare, con quali prerequisiti e con quale responsabilità umana quando l’automazione non conclude il percorso.
Governare eccezioni, aggiornamenti e dispositivi intermittenti
Le esclusioni sono modifiche di sicurezza, non semplici rimedi alla lentezza. Ogni richiesta dovrebbe indicare l’applicazione interessata, il problema riproducibile, il riscontro del produttore e il perimetro minimo necessario. Un’esclusione ampia per interi dischi o cartelle condivise richiede una valutazione particolarmente attenta. Una correzione alla configurazione applicativa può essere preferibile a un’eccezione permanente, ma va verificata in un pilota.
Gli aggiornamenti dell’agente e delle policy richiedono una distribuzione controllata. Un gruppo rappresentativo intercetta incompatibilità prima dell’estensione generale; una procedura di assistenza consente di raccogliere l’impatto reale sugli utenti. La guida al pilota EDR sviluppa questo processo. Il criterio di successo non è che nessuno protesti: è che le funzioni di protezione e i flussi di lavoro previsti siano entrambi verificati.
I portatili che si collegano raramente richiedono una gestione esplicita. L’assenza di eventi può significare computer spento, agente non funzionante o dispositivo non più gestito. Definisci quando contattare l’assegnatario e quando rimuovere una macchina dall’inventario, conservando le informazioni necessarie. Un dispositivo dismesso non dovrebbe restare tra quelli apparentemente protetti soltanto per mantenere positivo il grafico della console.
Misurare il servizio senza premiare il rumore
Un report con migliaia di eventi non dimostra automaticamente una protezione migliore. Sono più utili misure che rispondono a una decisione: quanti endpoint previsti comunicano, quanti hanno una policy corretta, quali allarmi attendono analisi, quali eccezioni hanno superato la scadenza. Specifica sempre il denominatore. Dire che il 98 per cento dei dispositivi è coperto ha significato soltanto se l’inventario è completo e il restante due per cento è identificato.
Per i tempi, separa almeno rilevamento, presa in carico, valutazione e contenimento. Un alert generato in pochi secondi può restare inosservato per ore; viceversa, un evento arrivato in ritardo può essere gestito rapidamente ma rappresentare comunque una lacuna di visibilità. I tempi misurati devono includere orari di servizio e condizioni contrattuali. Non presentare l’orario di una console come prova di presidio continuativo.
Un piccolo campione di casi chiusi permette di capire se le conclusioni sono motivate. Chiedi che siano visibili il segnale iniziale, le verifiche svolte, la decisione e l’eventuale modifica di policy. Nel rapporto destinato alla direzione elimina nomi di file sensibili e dettagli personali non necessari. Mantieni invece la conseguenza pratica: macchina sostituita, accesso revocato, aggiornamento completato, controllo aggiunto. La documentazione tecnica completa può restare in un archivio ad accesso limitato.
Collegare l’EDR alla protezione del dato
L’EDR contribuisce alla difesa dell’endpoint, mentre backup, identità e segmentazione coprono altri passaggi del rischio. Eventuali funzioni di rimedio o rollback del prodotto hanno un perimetro specifico e non sostituiscono un backup separato con test di ripristino. Una macchina protetta può contenere un account con privilegi eccessivi; una copia disponibile può essere raggiungibile con la stessa identità compromessa. Per questo il servizio deve sapere quali sistemi amministrano i repository, chi accede alle console e quali procedure permettono il recupero quando un accesso ordinario viene bloccato.
Durante una revisione periodica scegli un percorso completo: un allarme su una postazione, la verifica delle sue autorizzazioni, l’identificazione dei dati raggiungibili e la modalità con cui continuare il lavoro. Usa uno scenario di esercitazione, senza malware reale e senza provocare cifrature. La prova serve a trovare contatti mancanti, permessi troppo estesi e strumenti non disponibili nel momento previsto.
Il risultato utile per una PMI è una risposta proporzionata e ripetibile. Non una promessa che ogni attacco sarà fermato, ma un sistema in cui si sa che cosa osservare, chi decide e come verificare il ritorno al servizio. Quando queste risposte mancano, l’investimento prioritario può essere organizzativo quanto tecnologico. Il confronto con il fornitore dovrebbe partire da quei vuoti concreti, prima di aggiungere un’altra sigla al contratto.
Dalla guida a una verifica concreta.
Prendi un avviso dimostrativo del fornitore e identifica chi lo valuta, chi può isolare il dispositivo e come si verifica la chiusura. Non serve eseguire malware: serve rendere osservabile il percorso di risposta.
Risorse utili e progetti ufficiali
- Microsoft — Defender for Endpoint pilot
Documentazione pubblica. Pianificazione di un pilota EDR. La documentazione non include una licenza del prodotto.
I link ai repository identificano il progetto di origine, non una garanzia di sicurezza. Verifica licenza, manutenzione e compatibilità prima di adottare software. I siti esterni applicano le proprie regole sui dati.
RIFERIMENTI / TRASPARENZA
Le fonti. I limiti. Il contesto.
Questa guida collega indicazioni pratiche alla documentazione dei produttori e degli organismi citati. Versione del prodotto, licenze e configurazione possono cambiare il comportamento descritto.
- ThreatDown — Endpoint Detection and Response ↗threatdown.com
- WatchGuard — Endpoint Security ↗watchguard.com
Le indicazioni vanno applicate da persone autorizzate dopo aver verificato l’ambiente. Le immagini sono rappresentazioni concettuali.
Uso consapevole · limiti e responsabilità
Le guide e gli esempi hanno finalità informative. Non offriamo una garanzia di assenza di errori, continuità o idoneità a uno scopo specifico. Verifica il risultato prima di utilizzarlo e conserva copie degli originali.
L’uso avviene a tuo rischio e sotto la tua responsabilità, nei limiti consentiti dalla legge. Restano salvi i diritti e le responsabilità inderogabili. Queste indicazioni non sostituiscono un incarico professionale, un collaudo o una valutazione del tuo ambiente.
Esegui esempi soltanto su dati sintetici o copie autorizzate, dopo averne compreso gli effetti. La cancellazione dalla sessione rimuove i risultati dalla pagina: non revoca copie, download o appunti e non certifica la cancellazione sicura della memoria.
Porta il ragionamento nel tuo contesto.
Prepara i dati del tuo ambiente e le priorità. Il confronto parte già dalle domande utili.